本地 LLM 脱敏网关:零代码侵入,双向无感脱敏还原思路
现在日常写代码、排查线上 Bug 越来越依赖 AI,但经常会遇到不得不把内网 IP、线上数据库连接串、业务手机号 / 身份证、AK/SK 等信息带入上下文的场景,合规和隐私风险很大。
开源项目:Maskit(数据面具) — 专为大模型打造的本地隐私脱敏网关:请求自动打码,回复流式还原;支持 Cursor / Claude Code / Codex / Pi 等任意可配 Base URL 的工具。
核心设计与工作流程
它本质是一个运行在本地的代理网关,完全不需要改动下游业务代码:
- 零侵入接入:把客户端的 API Base URL 指向本地端口(如
http://127.0.0.1:18701),上游中转和协议对客户端透明。 - 上行自动脱敏:请求经过本地网关时,正则与词库匹配敏感信息,替换为带业务语义的轻量占位符(如
{{IP_PRIVATE_xxxx}}、{{PHONE_xxxx}}、{{CONNSTR_xxxx}}),原文绝不出网。 - 下行无感还原:模型回复经过本地网关时,自动对照映射表还原为真实明文;支持 SSE 流式实时还原,打字机吐字体验基本不受影响。
捕获模式
Agent 目标地址仍然是原始大模型 API 地址(比如 https://api.openai.com/v1),没有改任何代码配置。捕获工具(mitmproxy 这类中间人)在本机网络层截获这个出站 HTTPS 请求:
- Agent 发起请求 → 本机网络栈被劫持,流量拐到捕获程序
- 捕获程序拿到完整请求体 → 执行脱敏(敏感信息替换占位符)
- 脱敏后的新请求再发给上游大模型
- 大模型返回结果,同样被捕获程序拦截 → 还原占位符 → 返回 Agent
关键点:
- 大模型收到请求之前,本机出站流量已经被劫持处理
- 难点:HTTPS 加密,中间人劫持必须安装根证书,否则拿不到请求明文,无法脱敏;SSE / HTTP2 / QUIC 很容易绕过劫持,坑也多
本地网关模式
base_url 是 LLM 客户端 / Agent 里配置的API 基础地址,OpenAI 风格 SDK 都会读取这个参数,用来拼接 /chat/completions 这类接口路径。例如原生:https://api.openai.com/v1;改成网关后:http://127.0.0.1:18701/v1
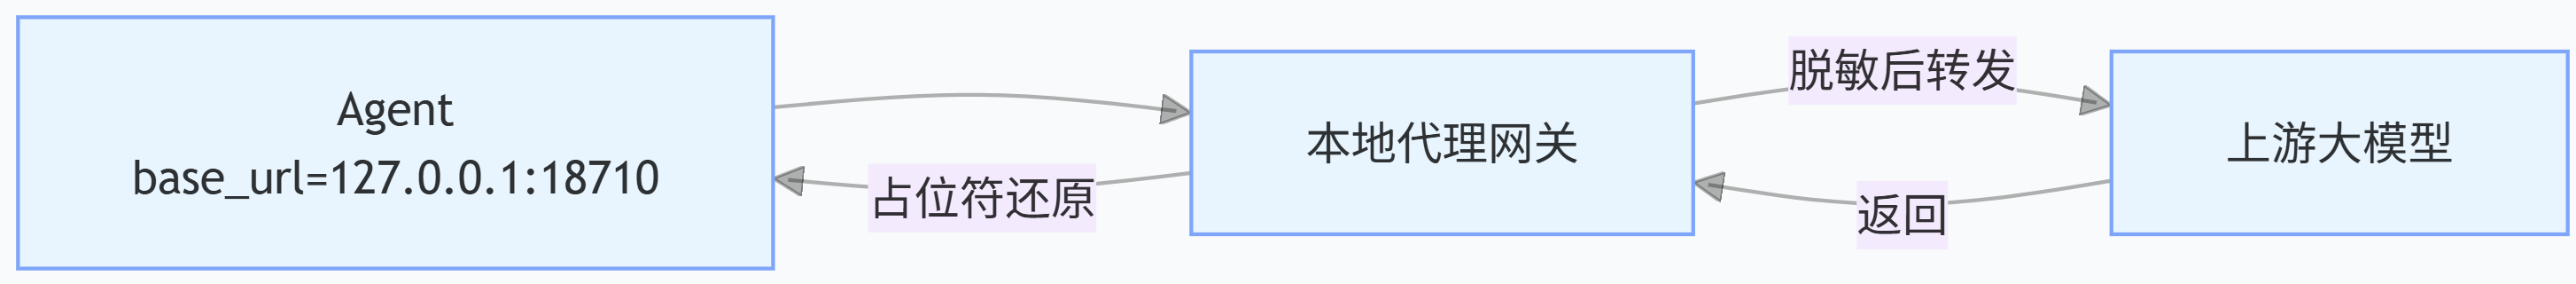
完整数据流
- 修改 Agent 的 base_url,指向本机运行的代理网关
- Agent 发起 API 请求,直接发给本地网关进程(不再直接访问大模型官网)
- 网关收到请求 → 上行过滤、脱敏(敏感文字替换占位符)
- 网关自己作为客户端,把处理后的请求转发给上游真实大模型服务
- 上游返回响应 → 网关下行还原占位符,SSE 流式场景逐块还原
- 网关把还原后的内容返回给 Agent
一句话区分:
- 捕获模式:Agent 目标不变,网络半路截获流量
- 代理网关模式:主动让 Agent 把请求发给网关(改 base_url),网关做转发,属于应用层正向代理,不是网络抓包劫持
极简对比
- 捕获模式:Agent 目标不变,网络中间抓包,在请求出去前改内容脱敏,不用改 Agent 配置;HTTPS 证书坑多、不稳定。
- 代理网关:改 Agent 配置,让 Agent 直接找网关;网关接收请求、过滤脱敏后再代请求大模型,应用层转发,更稳,也更好支持 SSE 流式。
Maskit 走的是后一条路:多端口反向代理 + 免装根证书。
两种方案的覆盖能力对比
脚本模式:罩不住,只能管「你自己写的那一次」
脚本脱敏的本质是业务层拦截——你在自己写的调用代码里,发请求前改一下 prompt。它的覆盖范围仅限于你主动编写、主动调用的那一段代码逻辑。
- 你用 Python 脚本手动调一次 API,它就能给这一次脱敏;
- Cursor 自己后台发的补全请求、Agent 自动多轮调用,全都是工具自带的 HTTP 客户端发的,跟你的脚本没有关系,自然就不会被脱敏。
- 想让脚本覆盖所有请求,你就得去改 Cursor 的源码、给每个调用点都插入脱敏逻辑,实际使用里基本不可行。
反代模式:能自动罩住,所有请求一网打尽
反代脱敏的本质是接入层拦截——你直接把工具的 base_url(API 出口地址)改成反代地址。
- 只要工具配置了这个 base_url,它发出去的每一个 HTTP 请求,不管是什么业务逻辑、不管是谁触发的、不管是第几轮调用,都会先经过反代。
- 不需要改工具的任何代码,不需要给每个功能单独加脱敏,只要配置一次地址,从代码补全到 Agent 多轮调用,从系统提示到文件上传,所有请求自动完成脱敏 + 还原。
- 换工具也一样,Aider、Claude Code、Codex 等等,只要支持修改 base_url,全部直接复用同一套脱敏能力。
深度脱敏能力
开箱规则与自定义词库
- 开箱即用规则库:内置约 19 类正则扫描规则(API Key / Token、PEM 私钥、数据库连接串、手机号、身份证、邮箱、银行卡、内网 IP 等),默认收敛核心隐私,尽量压低误报。
- 自定义敏感词与正则:可按分类管理内部人名、项目代号、敏感术语;支持整词匹配边界与自定义正则扩展。
自定义敏感词有三点实现细节:
- 热加载:后台增删敏感词后立刻生效,不用重启服务。
- 长词优先:拼规则时让长词先匹配。例如同时有「机要」和「机要文件」,短词优先会先把「机要」吃掉,长词再也匹配不到;长词优先则先检查完整长词,再回落到短词。
re:前缀 + 整词边界:re:打开正则高级模式,可写「所有以 TEST 开头的工号」这类规则;整词边界要求命中必须是独立词,避免「机要」误伤「机要害」这类连写。
多轮会话一致性:全局实体复用
普通做法往往按「对话窗口」建表:对话结束或超时就整表删掉。换一个对话,哪怕还是「张三」,也会生成全新代号,模型容易当成两个人。
Maskit 维护一张全局共享的双向内存对照表:只要是文字「张三」,在有效期内始终分配同一个代号 {{TERM_xxxxxx}}。绑定的是敏感实体本身,不是某个对话 ID。
两张表(双向配对)
1 | _RECENT_FWD:原文 → 代号(脱敏时查) |
每条记录带时间戳;最多约 2000 条;默认至少存活 24 小时。再次命中就刷新过期时间(滑动窗口,类似登录自动续期)。
像访客登记:张三今天登记拿到 A001;24 小时内再来还是 A001;每次来访都把有效期往后延。超时没来,才删掉这条记录。
「张三」完整走一遍
- 第一轮:客户张三
- 查
_RECENT_FWD,没有记录 - 生成新代号
{{TERM_bcdfgh}},写入双向表 - 发给大模型:
客户{{TERM_bcdfgh}} - 模型回复若带该代号,经
_RECENT_REV还原成「张三」
- 查
- 第十轮:张三的电话呢
- 再次查
_RECENT_FWD,命中已有记录 - 复用同一代号,并刷新过期时间
- 发给大模型:
{{TERM_bcdfgh}} 的电话呢
- 再次查
模型从头到尾看到的是同一个代号,实体不会串号。
自愈:历史残留占位符
上一轮模型输出的代号若没完全还原,被客户端带到下一轮 prompt(例如正文里直接出现 {{TERM_bcdfgh}}):
_seed_known()会去全局表查到代号对应原文「张三」- 自动把信息补进当前会话临时映射
- 模型再复述该代号时,仍可还原,不会直接失败
还原查询顺序
_lookup() 查代号时:
- 先查当前这次会话的临时映射表
- 找不到再查全局跨请求复用表
_RECENT_REV;命中则自动续期
重启怎么处理
全局表只在内存里,引擎重启会清空。启动时有预热:从本地 SQLite 历史事件库读取最近约 48 小时的映射记录,回填全局表。重启后旧对话里的占位符仍可解析。
重点:维护一张全局双向字典(明文 ↔ 占位符),带 24h 滑动过期、上限约 2000 条。同一敏感文字在有效期内跨所有请求复用同一代号。好处是多轮不认错实体,残留代号可自愈,重启可从数据库预热恢复。
防占位符被模型改写
整套思路是:少靠 prompt 叮嘱模型别改占位符,改用三层工程手段兜底。
1. 签发侧:纯辅音后缀,降低改写诱因
早期用 6 位十六进制后缀(如 83fc6a)时,模型容易把它当成 IP / 网段编号,自作主张改成 83fc00、83fc02,映射表对不上就还原失败。
现在改用纯辅音字母集 bcdfghjkmnpqrstvwxz 生成 6 位后缀:
- 没有数值可读性:不像 IP、编号,模型更少触发「算网段、改主机位」
- 不含元音:更不容易碰巧拼成有意义的英文词,减少被当成普通词去润色
兼容边界:老的 hex6 仍支持精确匹配还原,但不进宽松索引——_abc123 这类形态在代码、日志里太常见,放进宽松匹配容易误伤。
这只能降低改写概率,不能保证模型绝对不改。
2. 还原侧:三层匹配 + 后缀指纹兜底
实测里,模型就算改占位符,大多只改外壳格式,6 位后缀常常还在。restore() 从严格到宽松分三层:
- 严格完整匹配:
{{LABEL_后缀}},模型原样复述 - 转义格式匹配:
\{\{LABEL_后缀\}\},常见于代码、Jinja、命令行输出 - 宽松裸匹配:丢掉花括号后的
LABEL_后缀,只认表里已签发过的后缀
再加一层后缀指纹反查:标签被改但后缀没动时(如 {{IP_PRIVATE_abcdef}} → {{IPPRIVATE_abcdef}} / 全小写),用 6 位后缀反查,并对标签做大小写、下划线归一化。
后缀兜底硬约束:
- 只收录纯辅音后缀进兜底索引,hex 不参与
- 只在「带花括号」路径用兜底;裸文本半截后缀绝不按后缀猜
- 标签归一化后必须相等才能救:
IP_PRIVATE→IPPRIVATE可以;改成HOST直接拒绝 - 不同实体后缀撞车时,该后缀永久退出兜底——宁可还原失败可见,也不把 A 填到 B
流式场景配合分通道 pending 缓冲区 + _PARTIAL_RX:半截占位符先扣在对应通道,拼完整再还原,避免残片提前下发。
3. 红线:不做假自愈,失败可见优于静默错误
早期 hex 版本曾把 83fc6a 被改成 83fc00 后,按「同网段」瞎推回去:用户从没输入过的内容被当成还原成功,日志也分不出真假。
现在的铁则:
- 绝对不做算术推算(按后缀猜 IP、猜编号)
- 查不到映射就原样保留,
unresolved计数 +1,让用户看见异常 - 孤儿占位符不再套一层掩码二次污染;不做模糊匹配、算术猜测
一句话串全链路:辅音后缀降改写动机 → 原样返回走严格匹配 → 小改走三层正则 + 后缀指纹 → 大改坚决不猜、留异常痕迹。本质是格式设计 + 工程容错 + 失败可控,不依赖 prompt 约束模型。
毫秒级 SSE 流式接管
业务上要在反向代理层,对大模型的 SSE 流式响应做敏感数据脱敏 / 占位符还原。流式场景有个天然难题:
- TCP 传输的分片边界完全任意,不关心上层业务语义,很可能刚好把
{{PHONE_123456}}从中间劈成两半; - 如果收到一个 TCP chunk 就直接跑正则替换,半截占位符匹配不上,就会原样漏给客户端,脱敏直接失效。
同时有三个强约束:
- 不能等整个流结束再处理,否则就丢掉 SSE 打字机式的流式体验;
- 不能破坏 SSE 和 HTTP chunked 协议,否则客户端会断流、解析失败;
- 不能引入 Redis、磁盘这类外部存储。流式对延迟极敏感,而且这些状态只在单次请求生命周期内有效。
先分清两层协议:SSE 是内容格式,chunked 是传输方式。SSE 流式响应底层基本都走 HTTP chunked——边生成边发,一开始不可能知道总长度,所以必须去掉 Content-Length,用 chunked 分块发送。TCP 还会把 chunk 再切成更小的碎片,这就是占位符被从中间切断的根源。
技术栈与入口
基于 mitmproxy Addon 实现,全程进程内内存操作,无外部依赖:
- 在
responseheaders钩子识别Content-Type: text/event-stream; - 主动移除
Content-Length,接管flow.response.stream做自定义流处理,走 HTTP/1.1 chunked; - 字节层用增量 UTF-8 解码器,避免多字节汉字被切在 chunk 边界出现乱码;
- 状态全部存在进程内字典
sessions[sid],跟请求生命周期绑定,请求结束自动销毁。
若响应是 gzip 压缩,没法直接流式解析文本,会回退到整包处理,保证兼容。
两层对齐
第一层:SSE 事件级组帧 —— 对齐协议边界
这一层解决「TCP 乱切,把 SSE 协议本身拦腰斩断」:下游处理的最小单元必须是完整的 SSE 事件。做法是流式帧重组(Framing):
- 每个 TCP 分片解码后,先写入缓冲区
state["buf"]; - 不断查找 SSE 事件结束标记
\n\n,找到就切出一条完整事件交给下一层; - 没找到就留在缓冲区里,本轮什么都不返回。
工程上绝对不能返回空字节数组。mitmproxy 会把它当成 chunked 结束块 0\r\n\r\n,客户端会认为流已经结束而断开。没有完整事件时返回空列表 [],而不是 b""。
第二层:占位符级词法扣留 —— 对齐语法边界
事件完整了,占位符仍可能跨在前后两个增量块之间。这一层本质是简易的流式词法分析器(Lexer):token 不完整,就不输出。
两个核心设计:
- 分通道独立缓冲
SSE 事件里的正文、思考过程、工具调用参数是独立字段(通道)。每个通道单独维护pending缓冲区,避免上一个字段的半截占位符拼到下一个字段里,造成内容错位、字段吞噬。_PARTIAL_RX用来识别尾部半截占位符。 - 尾部半截识别与扣留
每次新文本到来,先和该通道 pending 里的残留拼接,再用正则检查末尾是不是疑似半截占位符——例如只剩{{PHONE_、半个花括号、甚至转义符\刚好被切断。- 末尾是完整普通文本:整段替换后直接下发,清空缓冲区;
- 末尾疑似半截占位符:前面完整的部分正常替换下发,这半截扣在 pending 里,等下一块再拼。
最多扣留 40 个字符,普通文本不会被卡住,用户基本感知不到延迟。
替换顺序仍是:严格 {{...}} → 转义形式 → 宽松裸 token,降低残片误替换。
流结束模板补帧
收到 SSE 结束标记、choice 结束或流关闭时,强制 flush 所有通道残留(_flush_pending)。残留文本不能裸塞进流里,那样会破坏 SSE 的 JSON 结构。做法是用该通道最后一条合法 SSE 事件当模板,把残留填进去,补发一条完整合规的 SSE 事件,客户端才能正常解析。
四个手法
- 流组帧(Framing):和 TCP 粘包拆包、WebSocket 帧重组同源,在应用层重新对齐协议边界;
- 词法前瞻(Lookahead Hold-back):用尾部少量扣留换输出完整性;
- 分通道状态机:按业务字段隔离状态,避免跨字段串扰;
- 模板补帧:协议层面兜底,保证输出始终符合规范。
效果是:零漏匹配、保住打字机体验、无外部依赖、开销可忽略,对客户端完全透明。
为什么不用 Redis / 外部缓存?
延迟不允许:流式是逐字符输出,每一块再走网络缓存,打字机体验就毁了。也没必要:这些状态都是会话级的,只在单次请求生命周期有效,进程内字典够用,还省掉序列化和网络开销。
怎么保证不内存泄漏?
状态按会话 ID 放字典,请求结束、连接断开时统一清理;每层缓冲区有长度上限(半截占位符最多扣 40 字符);会话带 TTL,异常断开也会回收。
占位符超过 40 字符怎么办?
业务占位符是 `` 格式,长度远小于 40。这个阈值按最大长度留了冗余,本质是延迟和覆盖率的权衡:阈值越大漏匹配越少,极端情况下扣留越多、延迟越高。40 是实测比较合适的点。
一句话:识别并接管 SSE 流,按事件切分,半截占位符分通道等齐再还原,边还原边下发,尽量保住打字机体验。
免装根证书与透明直连兜底
多端口反向代理(reverse 模式)
Maskit 给每个大模型上游单独分配本地端口,例如:
18701→ OpenAI18702→ DeepSeek18703→ Anthropic
客户端把 base_url 指到 http://127.0.0.1:18701。Maskit 按端口匹配真实上游,改写 Host / URL 后进入脱敏管线。
客户端 ↔ Maskit 是本机明文 HTTP;TLS 只发生在 Maskit 与远端 API 之间,所以不用安装根证书。只有抓 HTTPS 的普通 mitmproxy 模式才需要 CA。
透明直连兜底
若 mitmproxy 代理崩溃、启动失败或被关掉,自动拉起轻量转发(ThreadingHTTPServer)接管 187xx 端口:
- 默认
stop_mode="passthrough":不做脱敏,原样转发上游,避免 IDE 连不上端口 - 备选:
error(503)、block(释放端口) - 引擎启动时也会拉起兜底,尽量让端口保持可监听
IDE 只连本地 187xx;代理正常走脱敏;代理挂了自动切裸转发,尽量不断连。
实时日志、审计与费用统计
全链路日志
关键节点写入本地 SQLite(shield-events.sqlite3),三类事件:
MASK:请求脱敏(替换了哪些实体、耗时、模型名)RESTORE:响应还原(占位符换回、token 用量、首字节耗时)PASS:兜底透传转发记录
Web 面板可按会话合并查看,高亮对比脱敏前 / 后。敏感凭据不完整落库,只存预览 + sha256。
被动安全审计
还原完成后做只读扫描(不改原文),检测报错泄密、身份掉包、越狱 / 提示词注入、危险命令等;结果进审计面板,也支持手动主动探针。
Token 与费用
从 usage 字段累加输入 / 输出 token(SSE 也会持续累加),按内置或自定义单价估算费用,面板展示日用量与模型费用排行。
100% 纯本地
脱敏、还原都在本机内存跑;日志、审计、配置留在本机目录(Windows 会做权限加固)。
没有内置 Sentry / GA 一类遥测 SDK。网络出站只有:
- 用户自己配置的 LLM 上游 API(必选)
- 可选:拉取价格目录(默认关闭)
- 可选:桌面端手动检查版本
引擎不会自动上传日志或敏感数据到外部服务器。
完整请求路径(极简)
IDE 把 base_url 指到本地 127.0.0.1:18701:
- 代理正常:请求 → 端口路由 → transparent 脱敏 → 上游 LLM;上游 SSE 返回 → 流式还原 → IDE;同时写 MASK/RESTORE、被动审计、统计费用
- 代理崩溃 / 关闭:自动切 passthrough 透传,不脱敏,记 PASS 日志
控制面约在 5801 端口:Flask + WebUI,提供日志、审计、统计看板。
本地网关仍要注意的难点
即便走代理网关,下面几件事仍然难:
- 流式还原:跨 chunk 半截占位符、转义形态、通道隔离
- 脱敏准确率:正则易误判 / 漏判;JSON、函数参数、代码片段里的敏感信息要长期调规则
- 多协议兼容:OpenAI / Anthropic 等格式,流式与非流式、工具调用,目标仍是「改个 base_url 就能用」
- 并发与性能:正则与替换有 CPU 开销;请求间映射要隔离,不能串号
- 异常与状态:超时、断连、重试、取消时,映射表要正确清理或复用
为什么要做数据脱敏
- 合规要求:手机号、IP、身份证、数据库连接串等受《个人信息保护法》等约束,违规向第三方传输有合规风险。
- 防止数据外泄:服务商可能留存请求日志,部分场景还会用于训练;脱敏后原文不出网,即便上游泄露,泄露的也只是占位符。
- 保护业务机密:Agent 请求常带内部地址、业务数据、代码与配置;上游只做语义推理,接触不到真实内部敏感信息。
- 降低信任依赖:不必把数据安全完全押在厂商承诺上,在本地出口先把风险拦住,属于「数据可用不可见」的落地方式。
一句话总括:Maskit 用多端口反向代理,客户端连本机端口即可,免装根证书;代理异常时自动透传兜底;全链路日志、被动审计、token 费用统计落本地 SQLite;脱敏还原在本机内存完成,默认不把隐私自动上报外网。多轮场景靠全局实体复用表,让同一敏感文字在有效期内始终对应同一占位符。