CipherTalk 项目总结:本地数据处理才是人格克隆的底座
一句话:CipherTalk 是本地微信数据平台 + 派生检索层 + 多形态 LLM 应用(建议 / Agent / 人格)。最值得学的不是某个 Prompt,而是把脏聊天变成可控中间表示,再让模型在预算与降级护栏里工作。
稳定大模型生产的一条经验
自我克隆时,对话会先生成一张 card,而不是直接吐出一段克隆自己的 Prompt;生成的 card 再用 Zod 做规范化检查。
链路可以写成:
对话 → 生成 card → Zod 校验(架构兜底)→ 多场景渲染
核心做法:用工程手段兜住大模型的不确定性,把 LLM 从「直接产出最终结果」收缩为「产出结构化中间数据」。最后一公里的渲染与拼接交给代码。
克隆自己:六步流水线
1. 读会话消息(先约 6000,不够再全量)
先拉最近约 6000 条作为原料;近期太少、提炼不出稳定人格时,再回退全量历史。
设计意图:分身更像最近的你,同时控制初始数据量和成本。
2. 本地加工:buildPersonaCorpus 生成预算内语料
这一步纯本地代码,不调大模型:
- 把零散单条消息合并成完整一问一答轮次
- 统计发言频次、筛有效内容
- 按「近期优先 + 历史抽样」裁出约 1.4 万字高质量语料
1.4 万字是后续模型的输入预算:信息够用,又不轻易撑爆上下文。
3. 聊天大模型:extractPersona 提炼说话风格
把语料交给模型,提取语言表达特征,产出两样东西:
- 风格卡(card):语气、用词、口头禅、回复长短、常用句式。Zod 负责定义 Schema 并校验,把不可靠 JSON 收成可存、可改、可渲染的 card
- few-shot 示例:固定 3~10 条精选对话,完整拼进系统提示词
对应实现:personaLlm.ts。
4. 分块提炼深层个人画像
风格与人设内容是两个维度。聊天总量大,无法一次塞进模型:
- 最多拆成 12 块,每块调
extractProfileChunk抽个人信息、观点、经历、行事习惯 - 再
mergeProfile合并去重,得到完整 profile(你是谁、你怎么想、你在意什么)
5. 写入 personas 表
风格卡 + 深层画像写入本地库,后续分身聊天直接读这份基底。
6. 本地规则抽取问答对(persona_pairs,可选向量化)
同样不调大模型:按规则抽出「客户问 → 我答」,写入 persona_pairs。可选对问句做语义嵌入;用户提问时先找最像的历史问题,再参考当时的答法。
本地对话预处理才是核心底座
在 CipherTalk 里,微信数据的本地预处理不是喂模型前的打扫。它是整套 AI 能力的底座:优先级高于模型选型和提示词调优。LLM 与嵌入模型是上层执行器;本地处理锁住成本上限、效果下限、运行稳定性,以及多场景复用。
真实链路:AI 能力都先过本地层
模型消费的从来不是原始微信消息,而是本地已结构化的中间语料:
- 会话语义索引:
chatSearchIndexService拉索引,按规则切片段、双高水位增量更新,再让嵌入模型向量化;模型只负责向量生成与余弦检索 - 人格克隆:本地完成读消息、语音补转写、
mergeTurns、buildPersonaCorpus、renderProfileChunks,再交给 LLM 做风格提取、分块画像与合并 - 问答对样本库:邻接轮次规则生成问答对;可选只对问句向量化,运行时检索后注入提示词
- 自我 / 好友克隆:同一套语料加工底座,翻转角色位即可切换;群聊补语料、表情包收集也由本地规则完成
微信消息又碎又短、不是标准一问一答,所以必须先切段、合并轮次。否则单条嵌入语义稀薄、问答对全错位,模型能力无从发挥。
为什么优先级高于模型调优
1. 成本闸门在本地
token 与调用次数上限由本地硬规则锁定:
- 语义索引:首建最多 1500 条;单片段 600 字 / 15 条 / 20 分钟断段;单条嵌入 ≤1000 字;批量 64 条;高水位只补增量
- 风格克隆:语料封顶约 1.4 万字(近期连续 + 历史抽样)
- 深层画像:单块约 1 万字,最多 12 块,3 路并发,超出只留最近块
- 问答对:单会话最多 3000 对,问答各截约 160 字
- 语音转写:批量补转有上限,已转写走缓存
换更强模型不会自动降本;本地预算一放松,成本立刻失控。
2. 效果下限由本地定
- 不做
mergeTurns(3 分钟同人消息合并)→ few-shot 与问答对角色错位 - 单条直接嵌入、不按片段切块 → 语义稀薄,跨多轮召回失效
- 未做语音转写直接丢掉 → 风格侧写缺口语维度
- 不足 50 条可用文本直接拒绝克隆 → 效果必然失真时,不进入 LLM
切段、轮次合并、过滤、抽样决定效果地板;模型和提示词只能在这个地板上抬天花板。
3. 稳定性靠本地编排
- 语义索引:无新消息返回「已是最新」;旧向量维度不兼容则跳过
- 深层画像:单块失败跳过;合并失败降级为无画像,风格卡仍可保存
- 问答检索:向量失败回退字符 bigram
- 嵌入未配置:向量整体禁用,本地索引和规则问答对仍在
4. 一次加工,多处消费
同一套中间数据(mergeTurns 轮次、message_index)可组合支撑多条产品线:
- 语义片段 → Agent / 深度模式 / 分身聊天的长程记忆
- 预算语料 → 风格卡 + few-shot
- 全量分块 → 深层人物画像
- 邻接规则 →
persona_pairs→「像我回复」的检索式 few-shot - 角色位翻转 → 克隆自己与克隆好友共用加工链路
本地数据处理把「微信原始消息流」变成「模型可消费单元」,同时承担形态化、预算化、质量闸、复用化。LLM 与嵌入模型只是执行工具。
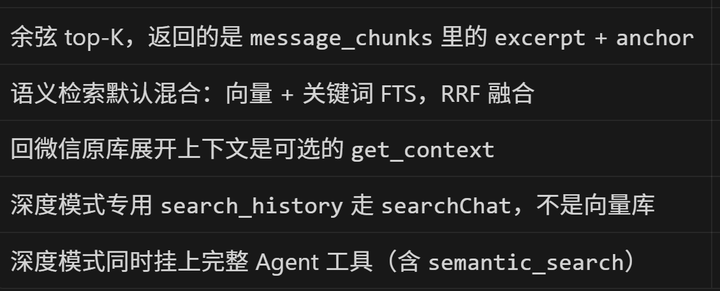
检索过程
RRF 算法
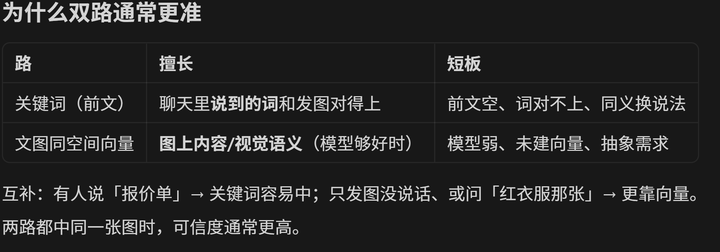
RRF(Reciprocal Rank Fusion,倒数秩融合)把多路检索结果(向量语义、关键词全文 FTS 等)无偏合并成一份统一排序。
关键词 FTS 检索
写入的是本地持久化搜索索引(SQLite:message_index + FTS),关掉 App 通常还在,不是纯内存缓存。
按需懒建:需要搜某个会话时,才把该会话(通常先是最近一部分)做成可持久检索的索引,再做关键词搜索;不够再往更早加深,完整后新消息增量补进同一份索引。不是启动时全量建完。
交叉编码器重排(Cross-Encoder Re-ranking)
粗召回 + 精排:先用混合检索(可搭配 RRF)召回 Top-N(通常 50~200 条),再用 Cross-Encoder 把查询与每个候选成对打分并重排。精准度高于纯召回侧融合;推理更贵、更慢,所以只对少量候选重排。
轻量化本地向量存储
没有引入 Milvus、Chroma、Pinecone、pgvector,而是 SQLite 文件存向量,应用层内存算余弦相似度:文件存向量 + 应用层暴力检索。
| 用途 | 库文件 | 表与核心内容 |
|---|---|---|
| 会话语义索引 | chat_vectors.db(cache 目录) |
message_chunks:片段文本 + embedding 浮点向量 |
| 克隆问答检索 | agent_personas.db |
persona_pairs:问答对,问句可选存 embedding(blob) |
实现要点
- 存储层:
better-sqlite3同步驱动,适合嵌入式。向量只是表里的浮点数组 / blob;SQLite 本身不做向量检索。 - 检索层:embedding API 生成向量写入库;检索时把候选载入内存,用 AI SDK 的
cosineSimilarity逐条算、排 Top-K。会话语义由messageVectorService.ts封装,人设问答由personaPairStore.ts封装。 - 定位:所谓向量库就是两个 SQLite 文件里的向量字段,计算全在应用进程内。
单用户 / 单会话量级通常可控,暴力检索够用;优先轻量、易部署。很多本地 AI 工具、桌面知识库也是这个思路。
用 better-sqlite3 操作 SQLite,BLOB 存 embedding;检索时 SQL 捞当前会话全部向量到内存,循环算余弦、取 TopK。没有库侧向量索引,用数据量小换最低部署成本。
迁移二开与整体分层
| 层 | 职责 |
|---|---|
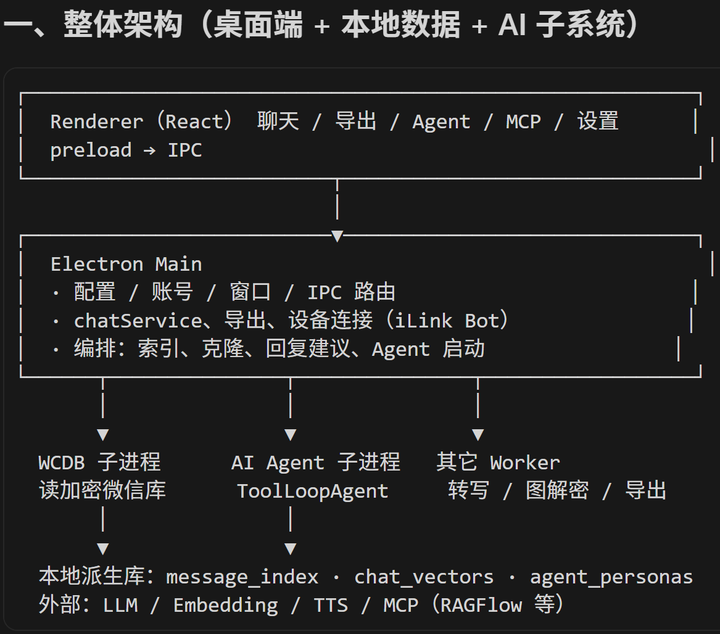
| 数据源 | 本机微信加密库(密钥 + 路径),近实时靠文件 / WAL,不是协议爬聊天 |
| 派生索引 | FTS 消息索引、会话向量、人设与问答对——按需懒建、增量 |
| AI 能力 | 回复建议、深度 Agent、人格克隆、分身聊天、MCP / Skills |
| 进程隔离 | 重活进 utilityProcess,避免堵 UI;AI 依赖 asarUnpack |
多条产品线共用本地底座,聊天 LLM、嵌入、检索、结构化抽取职责分离;贵的调用放在预算和闸门之后。
| 能力 | 模式 | 本地预处理 | 模型角色 |
|---|---|---|---|
| 普通回复建议 | 单次 generateText | 短上下文 | 直接出建议 JSON |
| 深度建议 | ToolLoopAgent | 长上下文 + 工具 | 先检索再写 |
| 自我 / 好友克隆 | ETL + 多轮 LLM | 轮次 / 预算 / 切块 | 侧写 card、few-shot、profile |
| 「像我」 | 建议 + 人设 | card 渲染 + pairs 检索 | 模仿语气 |
| 语义检索 | embed + 余弦 / 混合 RRF | 切段、高水位 | 嵌入模型 |
| 关键词检索 | FTS | 懒建 message_index | 无 LLM |
| 外部知识 | MCP | — | Agent 调工具 |
能学到的生产级经验
本地数据处理优先于调模型
微信消息碎、连发、多媒体。轮次合并、字符预算、抽样、最少条数拒绝克隆;向量按片段而不是按条;问答对用规则切,不靠 LLM 切全库。效果下限和成本上限主要由预处理决定。懒建 + 增量,而不是启动全量索引
FTS、会话向量都是「用到某会话再建 / 再加深」;完整后只追新(游标 / 高水位)。用第一次慢,换多数会话零成本。混合检索,不迷信单一向量
semantic_search:向量 + FTS + RRF;无嵌入则关键词兜底;persona_pairs 向量失败用 bigram。专名靠关键词,语义靠向量,生产要有降级路径。结构化中间表示(JSON + Zod),再渲染 Prompt
风格卡先落card_json,再buildMyPersonaContext/ 分身 system 不同拼法;Zod 校验、coerce、默认值、重试。可编辑、可复用、可演进。人设分层:怎么说 / 是谁 / 怎么回过
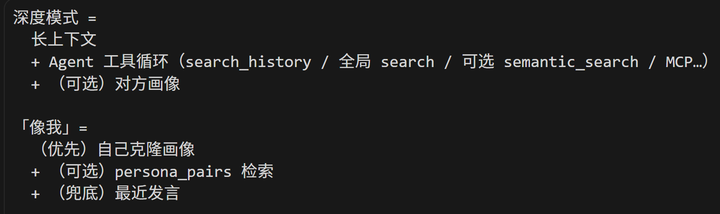
- card + 静态 fewShots:怎么说
- profile map-reduce:是谁、边界、反应
- persona_pairs:运行时相似「问 → 答」
与会话语义索引(聊过什么)分开。风格、知识、答法样本分库分检索。
Agent 有边界
工具超时、只读 MCP;深度模式可检索、不发送、不乱改记忆。生产 Agent = 能力开放 + 策略收缩。多供应商现实
宽松 JSON、重试、能力探测;视觉能力、嵌入维度不符就跳过旧向量。桌面多模型场景,解析与兼容层和业务同等重要。进程与 UX
克隆进度条;单块 profile 失败跳过;合并失败可无深层画像仍保存风格卡。部分成功优于全失败。产品能力正交可组合
深度 / 像我 / 对方画像 / MCP / 向量化——开关独立。降低门槛,也方便二开只增强一条线。分清本机资产与可迁移资产
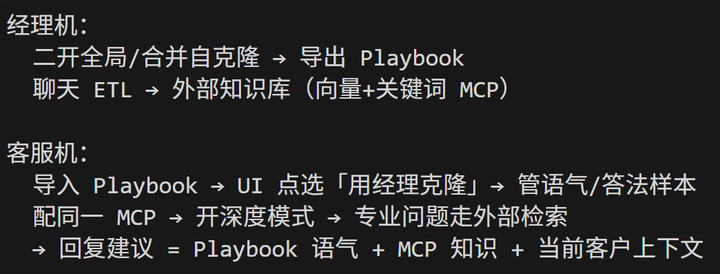
按session_id/account_id的chat_vectors、自克隆键,不等于可跨机话术包。做 ToB「经理赋能客服」时,要单独设计导出 Playbook + 外部 KB,不能指望拷库。
架构取舍
| 取舍 | 好处 | 代价 |
|---|---|---|
| SQLite 存向量 + 暴力余弦 | 简单、无运维 | 规模大时要换专用向量库 |
| 按会话自克隆 | 对这个人语气准 | 无全局自我,迁移难 |
| Agent 自主调工具 | 灵活 | 不保证每次都查 KB,需提示 / 策略加强 |
| 深度绑定本机微信 | 真数据、近实时 | ETL / 跨机要另做 |
可带走的经验清单
- 先定义可消费的数据单元(轮次、片段、问答对、card),再调模型
- 预算与闸门写在代码里(字数、条数、块数、最少样本)
- 检索多路 + 降级(向量 / 关键词 / 规则)
- 结构化抽取 → 存储 → 多场景渲染 Prompt
- 能力分层(风格 / 画像 / 答法 / 会话记忆 / 外部 KB)
- 懒建增量控制成本
- Agent 工具要策略(超时、只读、任务边界)
- 失败可降级、进度可感知
- 迁移与本机索引分开设计
检索聊天图片(一开双路)
Zod = 运行时校验 + 编译时类型推导 + 数据转换清洗 + Schema 组合复用 + 异步校验 + JSON Schema 导出。
附录:MaiBot 拟人化处理
核心目标:压低一问一答的机械感,复刻真人社群里克制、随性、碎片化的交流。不靠单一 Prompt,而是决策层、表达层、频率门控、社群学习、发送后处理叠加;关键创新是双 LLM 拆分。
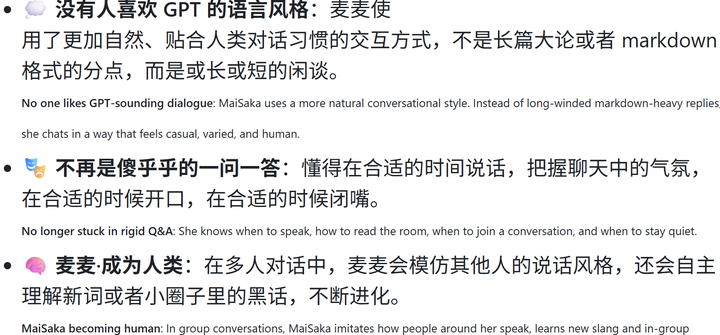
完整链路:
接收群消息 → 前置频率门控 → Planner(要不要发言、要不要调工具)→ Replyer(口语化回复)→ 真人化后处理 → 模拟打字延迟发送
双 LLM 分工
| 层级 | 模型定位 | 核心职责 | 输出边界 |
|---|---|---|---|
| Planner(决策大脑) | 思考规划专用 LLM | 读群氛围、节奏;判定是否参与、调工具、查记忆 | 不能直接输出聊天内容;只返回动作:wait / 调用 reply |
| Replyer(表达出口) | 口语生成专用 LLM | 结合人格、语境、社群话术产出日常短句 | 唯一合法发言通道 |
Planner 可以全程静默,不触发 Replyer,从根源减少逐条刷屏。
1. 时机门控:不是每条消息都接话
回复必要性评分 reply_necessity.py
- 加分:@机器人、直接点名
- 减分:哈哈、草、666、哦哦这类无实质短句;近期发言过密则限流
空闲退避 idle_backoff.py:群冷清、机器人许久没互动,进一步降低主动触发。没人聊时不强行搭话。
Planner 行为准则:优先旁观倾听;仅在被提及或对话题有兴趣时参与,其余保持安静。
2. 表达风格层
基线:风格平淡简短,参考贴吧、知乎、微博日常口语;拒绝浮夸长句。
Replyer 约束:日常生活化口语;禁用括号神态旁白、@前缀、多余符号、结构化排版;可随机切 1~2 字极简敷衍或慵懒语气。靠 Prompt 前置约束,没有单独的反 Markdown 拦截模块。
3. 社群进化学习
expression_learner.py:归纳什么话题适合什么语气,生成时随机注入jargon_learner:圈子梗、黑话入库,给 Planner 理解潜台词
4. 发送后处理
process_llm_response_segments:
- 清掉中文括号神态标注
- 长句按标点拆成多条短句分开发
- 小概率错别字,再隔一会儿补发修正
send_service加随机打字延迟
记忆分层
| 层 | 是什么 | 典型实现 |
|---|---|---|
| 工作记忆 / 短期 | 当前会话最近上下文 | _chat_history,群约 40 / 私聊约 60 条,超了就裁 |
| 中期(聊天回想) | 被裁掉或稍早的聊天,压缩成回想再召回 | mid_term_memory |
| 长期 | 跨会话摘要、关系、Episode、检索 | A_memorix:向量 + 图谱双路,可 query_memory |
| 人物层 | 对这个人的结构化了解 | 人物画像,挂在长期记忆证据上 |
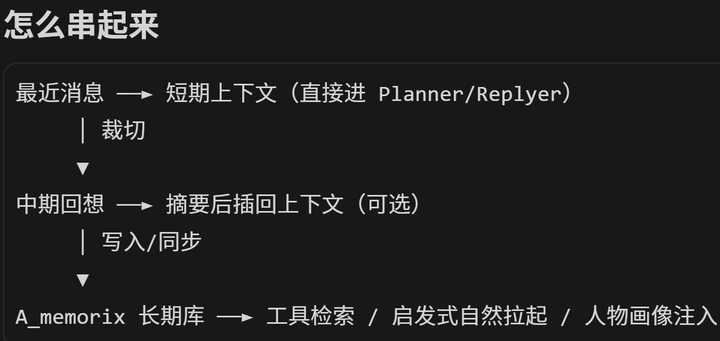
DualPathRetriever:向量 + 知识图谱
| 名词 | 通俗解释 |
|---|---|
| 稠密向量 Embedding | 把一句话压成一串数字,意思越近数字越靠拢 |
| FAISS | 向量高速检索 |
| BM25 / SQLite FTS5 | 关键词检索,补语义误差 |
| 知识图谱 | 三元组织成关系网,如「赖 xx,喜欢吃,甜品」 |
| Hop | 关系网跳转次数:1hop 直接关联,2hop 再跳一层 |
| RRF 加权融合 | 多路结果按权重合并排名 |
| PPR | 在关系图上扩散热度 |
| 后验图门控 | 过滤无效、矛盾的关系记忆 |
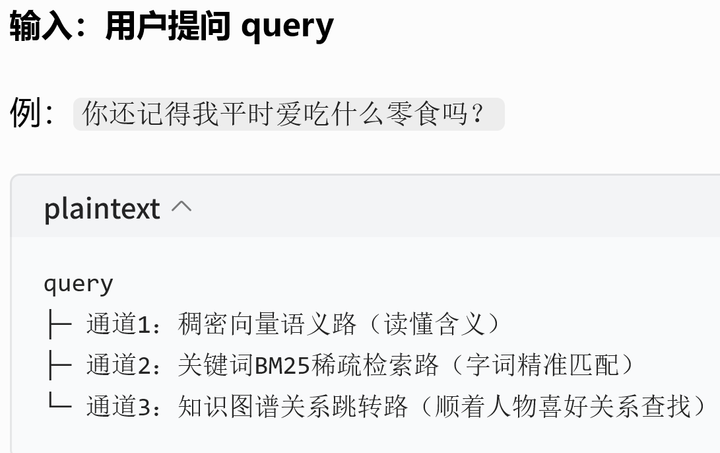
通道 1:向量语义(权重最高)
问句转向量,FAISS 查段落向量池和实体 / 关系向量池;命中关系时顺带拉出佐证原文。
通道 2:BM25 关键词
jieba 分词 + SQLite FTS5,专名、昵称更稳。
通道 3:图谱关系跳转
从问句抽种子实体,1~2 hop 扩边,带出可信度与佐证条数。
融合时:段落用加权 RRF(向量约 0.7、关键词约 0.3);关系三元组按佐证条数和可信度打分;再用 alpha 平衡闲聊段落 vs 关系提问。可选 PPR 热度扩散,最后用后验图门控过滤矛盾与低可信条目,截 Top K 送给模型。
三者分工:jieba + FTS5 抓字面;自研稀疏矩阵图谱挖人际羁绊;FAISS 抓语义相近片段。SQLite 可以充当轻量向量库,但原生不行,必须靠扩展;单机小体量场景也替代不了 Milvus、Qdrant。
GraphStore:基于 SciPy 稀疏矩阵的内存知识图谱
定位:不是 Neo4j 这类图数据库,是自研内存图存储。文本抽三元组 → 写入 GraphStore,和向量库联合检索,提供 PPR 显著性扩散、BFS 路径召回。
| 变量 | 作用 |
|---|---|
_nodes + _node_to_idx |
实体名 ↔ 矩阵下标;名称统一 lower().strip() |
_adjacency |
SciPy 稀疏邻接矩阵,存拓扑权重 |
_edge_hash_map |
(src_idx, dst_idx) → 关系哈希;关系文本、时效等元数据放 SQLite |
持久化:graph_adjacency.npz + graph_metadata.json;边关系映射落地 SQLite,支持快照。
- 读多写少(查询、PPR):CSR —— 取邻居、矩阵乘法快
- 频繁增量随机写:LIL —— 原位修改;批量后再转回 CSR/CSC
- 扩容:LIL 直接
resize();CSR/CSC 用bmat拼零块,禁止全量稠密复制
边写入:同一 (src,dst) 批内重复边覆盖权重;增量模式 LIL 改 A[i,j];批量模式构造 delta 再相加。配套 update_edge_weight、deactivate_edges(软删)、delete_edges。
PPR:出度归一化转移矩阵上幂迭代,给实体显著性打分。find_paths 用双向 BFS,限制深度与路径数。connect_synonyms 按相似度阈值加同义边。生命周期有衰减、修剪弱边、清理孤立节点。快照写入新目录后原子改指针,避免半残主索引。
CSR:按行打包非零值,适合取下游邻居和 PPR;改单个格子很慢。
LIL:每行一个小列表,单点写入快、可扩容;矩阵乘法和批量遍历慢。
链路:
1 | 文本/摘要 → 三元组抽取 → GraphStore(节点/边写入) |
可带走的 GraphStore 实现提示词
1 | 请在本项目中实现一套轻量知识图谱存储与检索组件,架构对齐 MaiBot/A_Memorix 的 GraphStore 设计理念(可重新实现,不要整文件抄袭授权不明代码)。 |
Event + 命名 Hook 双模式扩展点
适用:要给第三方 / 插件插进来,核心又不想被改乱;流程长、决策点多;需要可中止 / 可改参,又要防扩展拖垮主流程。
- Event:粗粒度阶段广播,数量少、命名稳。例如
app.started/message.received - Hook:细粒度手术切口,每个挂点必须有 HookSpec。例如
chat.receive.before_process
Event 表示走到哪一站了;Hook 表示这一刀能不能改 / 停。不要做成同名同义的两套 API,也不要在每个私有函数里乱打 Hook。
可带走的 Event + Hook 实现提示词
1 | 请在本项目中设计并实现「Event + 命名 Hook」双模式扩展点系统。目标是让核心流程可扩展,但扩展可控、可文档化、可演进。不要引入 Django signals / Blinker / pluggy 作为主框架(可参考其思想,但请自研清晰的 API 与契约)。 |