Jev 的相关思想:只给任务最需要的上下文
Jev 可以理解成:一个只给你的任务最需要的上下文的 Harness。它会在后台做一批很快、几乎无感的决策:
- 你说话的时候,先读一遍:是新任务、追问,还是在纠正?这句插话要不要立刻打断?
- 工具返回的时候,先挑一遍:输出里哪几块现在有用,哪些是重复和噪音;测试日志里失败的留下,一遍遍刷屏的去掉。
一、蜂群
面对困难或大型任务,可以用一种蜂群协作方式。原先让几个 agent 一起查一个难题,最难的往往不是派活,而是它们如何交流:什么都不说,各自走同一条死路;什么都说,每个人的上下文里全是别人的聊天。
于是让 Jev 站在中间:每一只蜂的发现,由它判断值不值得共享;只有对另一只蜂真正有价值的信息,才会作为上下文传过去。
二、全链路判定:一张图看清旁路治理
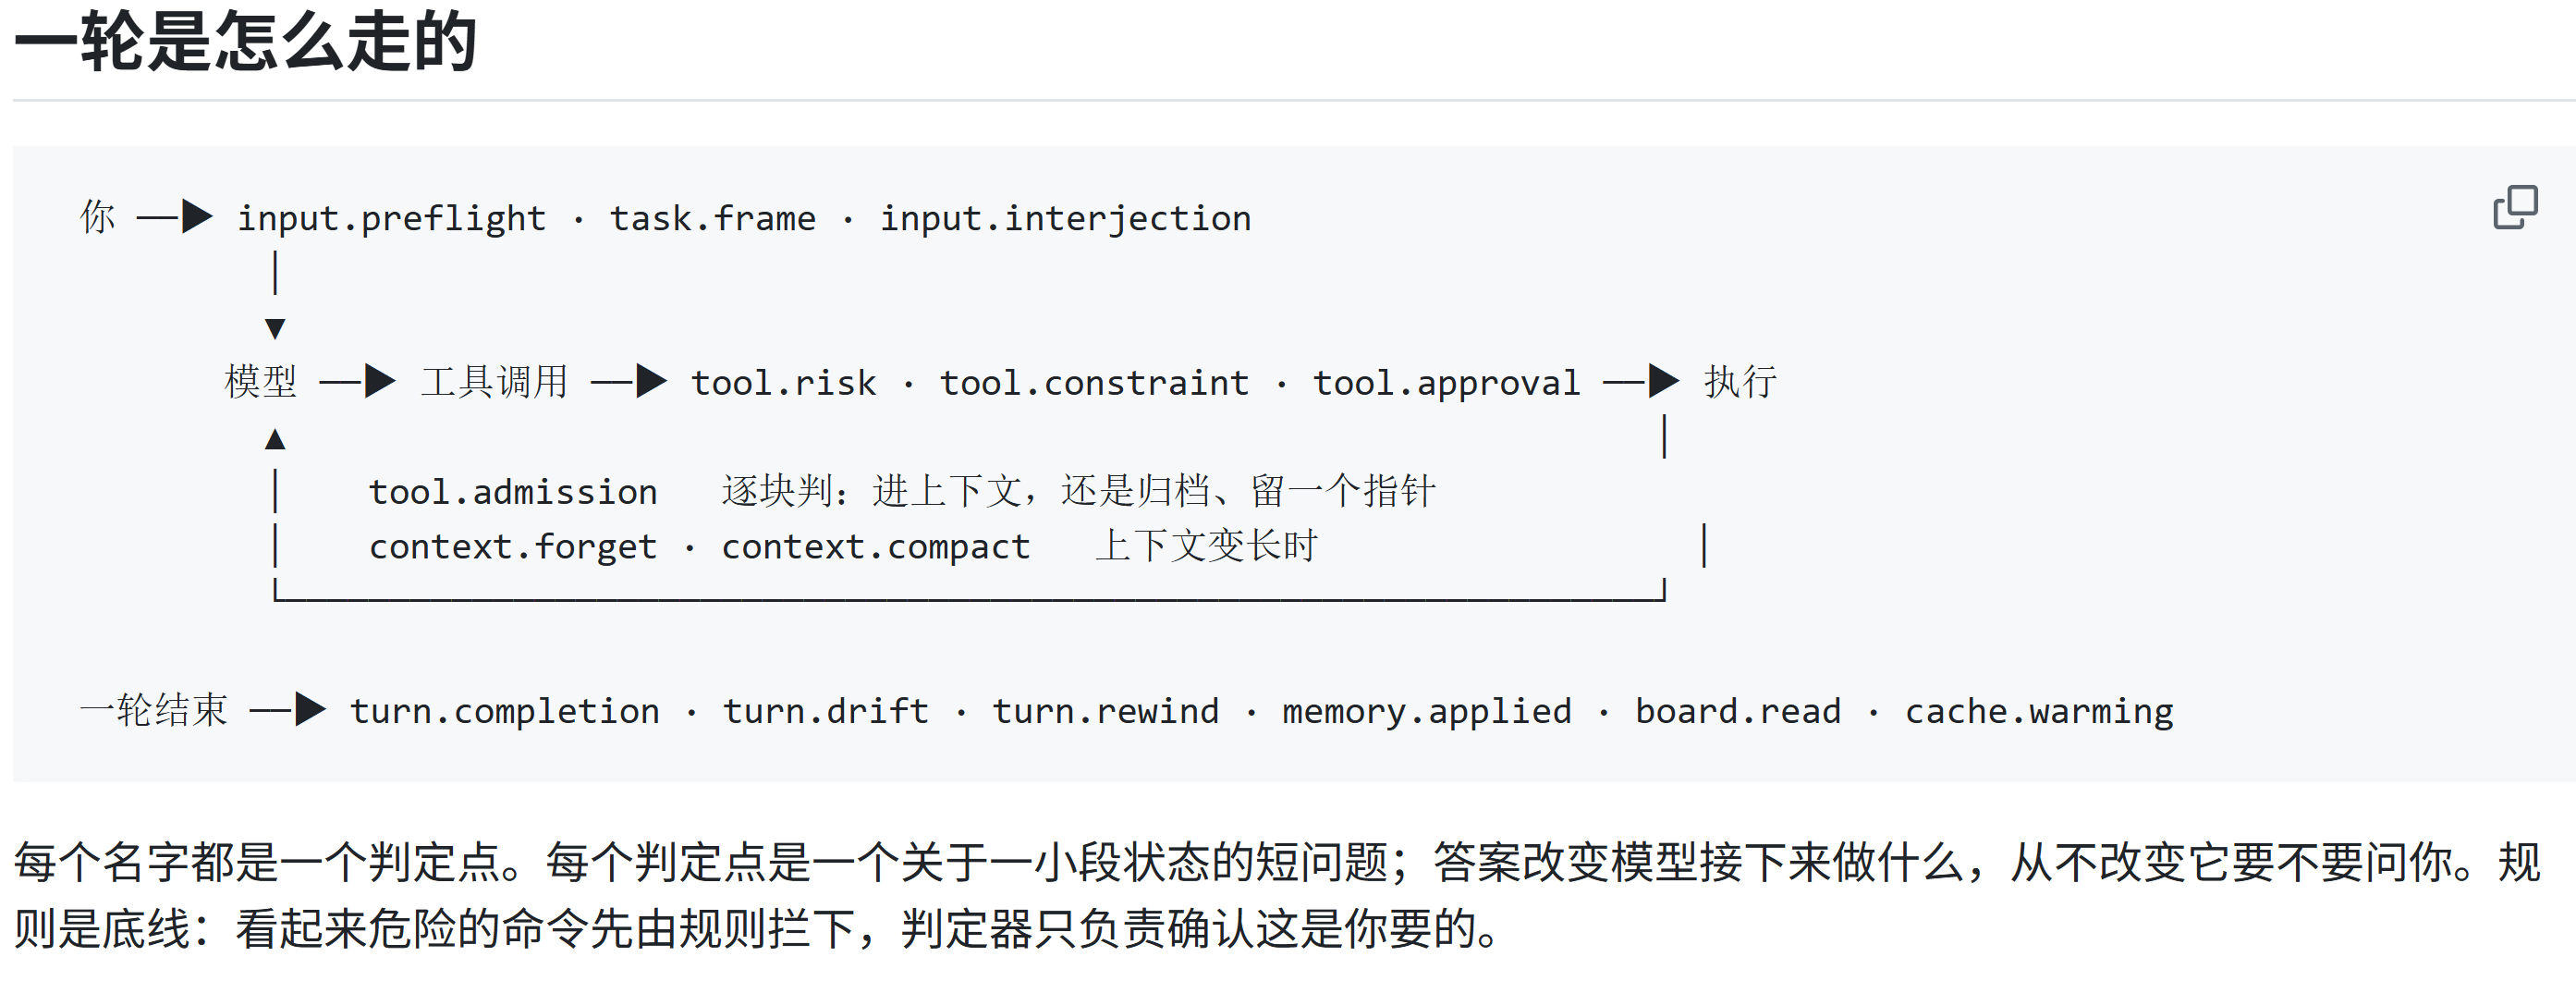
1. 输入阶段:用户输入 → 主模型
包含 input.preflight、task.frame、input.interjection 三个判定点。
- 主流程:用户输入不会直接交给主模型,先经过输入层的全套判定预处理,再把规整后的纯任务输入交付给模型。
- 各判定点作用:
input.preflight:输入预检,判断消息类型(闲聊 / 追问 / 正式任务)、任务难度,决定匹配的思考强度、是否加载工具能力,也是「自动模型分级路由」的执行节点。task.frame:任务框架识别,判断是新任务、约束修正、用户纠正还是普通续问;只有任务发生变化时才重写任务帧,避免重复构建上下文。input.interjection:插话中断判断。若代理正在执行时收到新消息,判定是立刻打断,还是等当前步骤结束再处理。
2. 执行阶段:工具调用 → 工具执行
包含 tool.risk、tool.constraint、tool.approval 三个判定点。
- 主流程:主模型生成工具调用指令后,不直接执行,先经过安全与审批关卡,通过后才正式执行工具。
- 各判定点作用:
tool.risk:风险等级评估,判断命令是否存在不可逆后果,划分风险层级。tool.constraint:约束边界校验,检查调用是否违反用户预设的规则、权限与操作边界。tool.approval:执行审批,对应「Jev 审批」模式——低风险操作直接放行,高风险操作拦截并询问用户。
核心原则:规则是底线,判定器只做确认。明显危险的命令先由硬编码规则拦下,判定器只负责语义层面确认「这是不是用户想要的」,安全红线不交给模型。
3. 回流阶段:工具返回 → 模型上下文
包含 tool.admission、context.forget、context.compact 三组机制。
- 主流程:工具执行完成的原始结果,不直接塞进模型上下文,先经过价值筛选与上下文治理,再回流给主模型进入下一轮推理。
- 各机制作用:
tool.admission:结果准入判定,逐块评估工具输出的每一段内容;高价值信息直接进入上下文,低价值、冗余内容归档留存、只保留指针。context.forget/context.compact:上下文生命周期管理。上下文长度膨胀时,自动判定哪些结果已经过期可丢弃、哪些内容可压缩,始终维持上下文水位。
4. 收尾阶段:一轮执行结束
包含 turn.completion、turn.drift、turn.rewind、memory.applied、board.read、cache.warming 六个判定点。
- 主流程:每一轮任务执行完毕,不直接进入下一轮或结束,先走一遍「质检 → 纠偏 → 沉淀 → 预热」的完整闭环。
- 各判定点作用:
turn.completion:完成度校验,确认任务是否真的执行完毕、有没有结果验证。turn.drift:跑偏检测,检查执行过程是否偏离原始任务目标。turn.rewind:回退决策。若反复失败,判断是否进入死路,是否退回上一个检查点重跑。memory.applied:经验管理,判断是否沉淀本次经验,以及历史经验是否被有效执行;长期不用的经验自动退役。board.read:人话看板提取,筛选本轮关键进展,交付给表达模型生成自然语言进度。cache.warming:缓存预热,预判用户后续交互概率,决定是否续期缓存,保持响应速度。
三、核心设计思想
- 切面化治理(AOP):主流程是极简的线性执行链路,所有治理、风控、过滤、优化逻辑全部横向切入,和主执行流完全解耦。主模型只专注任务本身,甚至感知不到判定点的存在。
- 决策与执行彻底分离:流程类、判断类、管控类工作全部下沉给 Jev 判定层;主模型不操心流程、不考虑规则、不处理冗余,算力全部用在核心任务上。
- 全链路原子化判定:每个判定点只回答一个极小的短问题,只改变模型接下来的行为,不越权替用户做决策,职责边界清晰可控。
这张图本质是 Mu「Only what’s needed」核心哲学的工程化落地:通过遍布全链路的旁路判定,只让任务最必需的信息、最安全的操作、最有价值的结果进入主链路。
四、自动模型与缓存取舍
GPT-Load 新版加了 自动模型 功能:让 Jev 判断这次任务适合哪一档,自动调度,省掉本地手动切换模型、思考档位的操作。Jev 负责选档,真正思考和输出的仍是配置好的预设模型。
切换模型会导致缓存失效,所以这个实验性功能有一定代价。目前做了一些优化:同一个指令(不是整个会话)会沿用已选档位,不会每次请求都重新判断。这样保证一个任务只判断一次,也尽量避免无谓的模型切换。
但会话里多个指令,仍会按预设提示词分别判断。例如:方案设计、架构沟通期间用高档位;方案确定后开始实施,切到普通档。损失一次缓存,换质量和成本的平衡。
切换时机由用户自己写的预设提示词控制。自动挡肯定没有手动挡精准,这是不可避免的——和开车一样,按需要选自动或手动即可。
如果不想切模型,也可以用同一套机制自动切思考强度。某些思考模式仍会破坏缓存,那种场景就不适用。