【公司AI编程培训】从零基础入门到团队工程化,附 AI 中转站科普与自建运营
本次培训能解决什么问题
Todo
- AI 编程到底是怎么工作的?
- Token、上下文、Prompt 到底是什么?
- Codex / Claude Code 和 Trae / Cursor 有什么区别?
- AGENTS.md、Skill、MCP 分别解决什么问题?
- 什么东西值得做成 Skill?
- 什么需求可以直接让 AI 做?
- 什么需求应该先 Grill?
- 什么需求应该使用 Trellis?
- 如何安全、合理地使用公司的 AI 中转站?
第一章:从 AI 到 Coding Agent
1.1 AI 的发展历程
1950 年图灵提出“机器能否表现出智能”的问题。往后的几十年,人们对这个问题展开了深入研究。我们已经从讨论机器能不能像人一样交流,发展到了让 AI 直接参与软件开发。
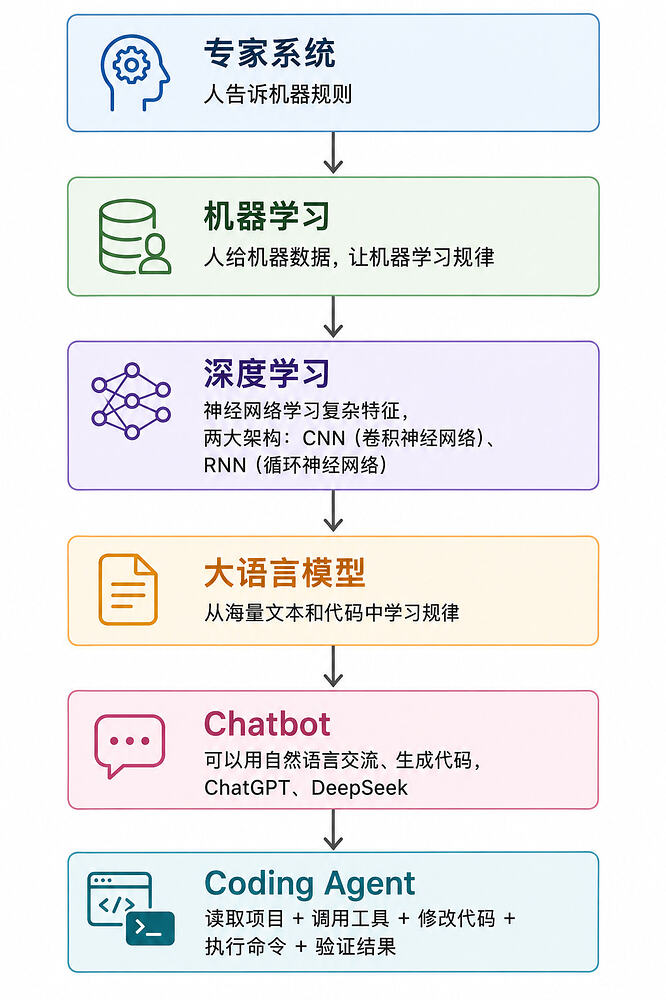
所以我们今天讨论的“AI 编程”,已经不是怎么让 ChatGPT 帮我们写一个 Java 方法了。
我们真正要学习的是:怎么管理和使用一个 Coding Agent。
1.2 大模型是怎么工作的
1. 切片:把文字切成 Token
模型不会直接以“字符串”的形式处理我们输入的文字,而是先通过 tokenizer 将文本转换成 Token,再转换成模型可以计算的数字表示。
- 什么是 Token:它是模型处理语言的最小单元。一个 Token 可以是一个汉字、一个词、一个英文单词,甚至只是几个字母或标点符号。
- 例子:“我喜欢吃苹果” 可能会被切分成
["我", "喜欢","吃","苹果"]这 4 个 Token。
2. 核心工作:预测下一个 Token
模型的所有“智能”,都建立在根据上文预测下一个最可能出现的 Token。
- 找规律:在训练阶段,模型从海量的数据中,学会了文字之间的搭配概率和逻辑关联。
- 概率计算:当输入一段提示词时,模型会分析当前所有的前文字符,计算接下来可能出现的每个 Token 的概率。
- 例子:输入“举头望明”,模型计算出下一个 Token 是“月”的概率可能非常高,于是输出“月”。
AI 每次工作时能看到的信息是有限的,我们把它叫做“上下文”,因为硬件和模型架构的原因,上下文不能无限大。
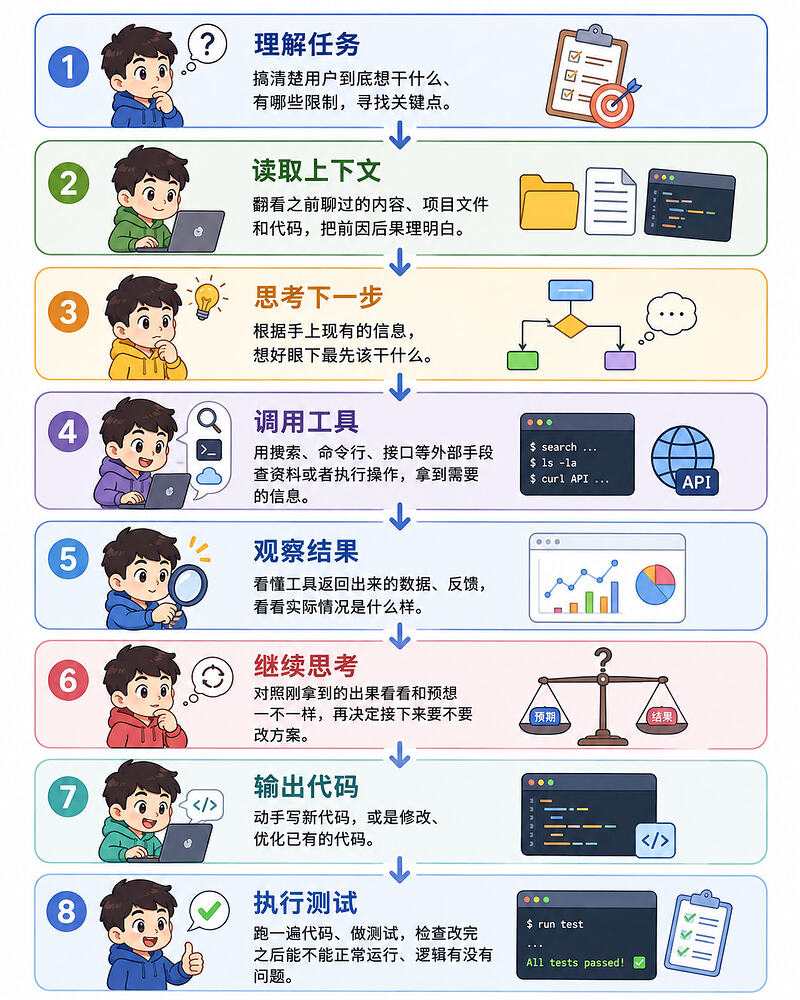
1.3 Coding Agent 是怎么工作的
传统的“对话式 AI”(ChatGPT、豆包),只能一问一答,无法去项目里帮我们写代码,所以编程 Agent 出现了,目前分两大类:IDE、CLI,APP 是套了壳的 CLI
- IDE:Trae、Cursor、Qoder,把项目进行向量化,构建索引库,通过检索索引库来构建上下文和处理任务;上下文长度到达临界值时会提示新开窗口还是压缩,往往都带代码补全功能,比如 Cursor 的代码补全是我认为做好用的。
- CLI:Codex、Claude code,更依赖文件搜索、读取、命令执行等工具动态构建上下文;上下文长度到达临界值时会自动执行压缩(Compact)。
工作流程
第二章:AI 编程的基础设施——AGENTS.md、Skill 与 MCP
2.1 AGENTS.md
2.1.1 AGENTS.md是什么
AGENTS.md 是个开放标准,官方介绍:https://agents.md/
AGENTS.md是编程 Agent 的项目规则说明文件,用于告知 Agent 项目规范、注意事项与开发约束,想让 AI 写出符合我们风格的代码,它就是关键。
比如 Agent 加载项目后,会去读 AGENTS.md,能很清晰快速的知道构建命令是什么、测试怎么跑、哪些规范必须遵守、代码改完要做哪些验证等等,是为了让 Agent 按规矩做事、减少出错、保持交付质量。
一个简单的 AGENTS.md
1 | `# 项目规则` |
2.1.2 AGENTS.md 加载机制
加载顺序:
全局配置(~/.codex) → 项目根目录 → 当前工作目录。
每一层的 AGENTS.md 会逐层拼接在一起,离当前目录越近,优先级越高。
举个例子,假设我们的项目结构是这样的:
1 | my-monorepo/` |
我们在 frontend/ 目录下启动 Codex,它会先读全局的 ~/.codex/AGENTS.md,再读 my-monorepo/AGENTS.md,最后读 my-monorepo/frontend/AGENTS.md,最终三份文件的内容拼接在一起。
注意:
- Codex 默认限制是 32 KiB,超过限制会截断。
- AGENTS.md 不能实时加载,改了一行规则,需要重开会话。
2.1.3 Claude Code 怎么用 AGENTS.md
Claude Code 对应的规则文件是 CLAUDE.md,在里面增加一句 @AGENTS.md,就会自动加载 AGENTS.md 的内容
注意:@file 这种引用语法是 Claude Code 的能力,不是 AGENTS.md 本身的通用能力。
2.1.4 使用 /init 去初始化项目的 AGENTS.md
输入 /init ,agent 会先扫一遍项目,让它知道我们的这个项目大概是什么样的架构体系,比如项目目录怎么分、技术栈是什么、启动命令在哪里、测试命令是什么、README 里有没有写注意事项。
- 扫描项目结构,比如目录和文件
- 分析依赖,比如
package.json、pom.xml、requirements.txt- 读
README.md,找启动命令和测试命令- 生成一份基础项目说明
它只能生成起点,看到的更多是项目表面信息,建议在项目初具规模之后再用它生成项目规则。
2.1.5 AGENTS.md 要持续完善
/init 只是帮我们生成了一个初始规则,但是它并不知道我们团队平常是怎么开发的,也不知道这个项目历史上出现过哪些问题,以及踩过哪些坑。
所以需要把这些高频、容易出错和需要长期遵守的规则,及时补充到 AGENTS.md 里。
但是有些人可能不懂怎么写才是一个正确的规则指令,比如我们这样写是不行的:
- 保持代码优雅
- 注意可维护性
- 遵循最佳实践
上面的这些话都太宽泛了,不够明确。所以我们应该这样去明确规则指令,比如需要明确动作:
- 禁止使用System.out.println,统一用logger
- 严格按照设计文档中定义的字段名称去命名,不要擅自修改
- 如果方法参数超过3个,一定要由我确认是否封装到一个dto中
- 避免循环中调用访问数据库的方法,尽量使用批量查询,批量修改,批量插入
如果我们在和 Agent 交流时重复提醒过多次,就可以考虑把这个问题写入 AGENTS.md ,比如:gpt 非常爱拆分方法,不爱写注释,我们就可以在全局 AGENTS.md 里加上:
- 默认禁止新增 private 方法,如果你认为有必要拆(大于3处调用,代码行超过50行),务必由我确认。
- 用户提供的设计文档、业务描述、字段映射、统计口径、状态流转、异常分支,必须映射到对应实现代码附近的业务注释中。
一个比较标准的 AGENTS.md:
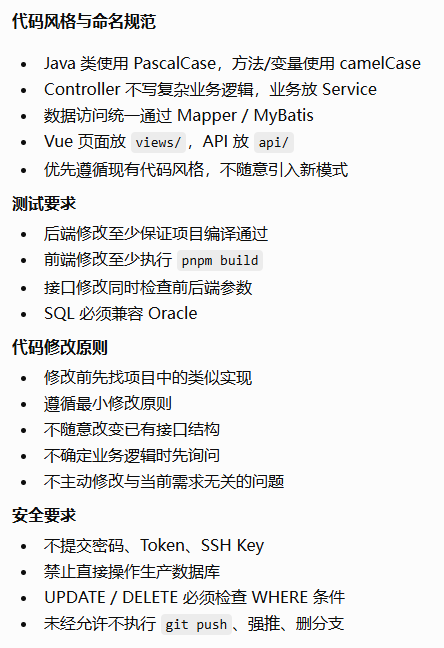
2.1.6 AGENTS.md 要精简
就像我们刚才说过的,当上下文很长时会有失忆的风险,工具本身有很多内置提示词(权限控制、工具使用、安全约束、代码风格),所以尽可能写最关键的、agent 自己推断不出来的那些进 AGENTS.md ,节省上下文。
2.2 SKILL
不要为了用而用,很多时候其实并不需要,硬上反而是个累赘。
2.2.1 什么是SKILL
官方解释:skill 是可复用的指令集,用于扩展 agent 在特定任务上的能力。
简单来说就是:skill 就是把一个复杂的、多步骤的任务流程,写成一个可以一键触发的指令集。
比如说,我们日常开发中需要做代码审查,所以可能就要做这些流程:
- 先跑
git diff看看代码都改了哪些文件内容- 再检查下看看是否有代码逻辑错误的
- 然后再看看有没有安全风险以及需求边界的问题
- 最后输出一份代码开发逻辑说明报告
如果我们每次执行这些流程的时候都要跟 ai 重新说一遍这个流程内容,那就太麻烦了,所以可以把整套流程封装成 skill,命名为:.codex/skills/review/ ,那我们以后只要输入/review,ai 就可以执行上述流程。
如何触发
一般有两种触发方式:
- 手动触发:我们直接输入
/skill-name,比如/review- 自动触发:agent 根据我们说的话,去寻找所有 skill 中 description 相匹配的,然后触发
如果不希望它自动触发,可以这样设置:
2
3
4
├── SKILL.md
└── agents/
└── openai.yaml
codex:
在
agents/openai.yaml中配置:
2
allow_implicit_invocation: falseclaude code:
在
SKILL.md中的头中配置:
和AGENTS.md的区别
- AGENTS.md:项目事实说明规范,目的是告诉 ai 这是什么项目以及规则约束
- Skill:任务执行流程,目的是为了告诉 ai 特定任务怎么做
2.2.2 SKILL的使用场景
两种类型
个人全局 skill:
这个是我们最常用的,一般放在 ~/.codex/skills/ 下面,这是我们个人的全局 skill。
装在这里的 skill,我们自己所有项目都能用到,但别人用不到。一般我们从 skill 市场安装的,或者我们自己写的个人 skill,都是放这里。
项目级 skill:
顾名思义,就是放在项目的 .codex/skills/ 下面的,这是项目级别的 skill。
装在这里的 skill,只有这个项目能用,而且提交到 git 后,团队所有人 clone 下来就都能用到。
团队协作下的问题
假如我们团队有一个安全评审流程,要求检查:
- 公司特定的密钥规范,不能直接写死在代码里,要存到数据库中
- 免登接口必须要过安全网关
- 涉及到金额的功能必须要过脱敏系统
- 按照公司模板输出文档
日常开发过程中,每次到了做安全评审的时候,我们都要跟 ai 重新解释一遍这些要求。
有时候忘了说某一条,ai 就按通用逻辑来,结果漏掉了公司特定的风险点。
说到这里可能会有人想到一个点,那就是这些要求为啥不写到 AGENTS.md 里面去呢?
AGENTS.md 只能要求 agent 尽可能的按照我们的规范去写代码,但没办法执行完整的评审流程。
全局 skill 能解决什么问题
- 插件商店中有很多值得用的通用 skill,比如:grill-me、fronted-design,所有项目都适用。
- 我自己总结了一下小经验、小工具,但是我不想告诉其他人,那就可以使用全局 skill。
全局 skill 解决不了哪些问题
- 全局 skill 是跨项目通用的,没法解决指定项目的要求,比如:项目 A 是支付系统,对安全要求非常高;项目 B 是一个外包项目,要求相关开发文档非常全。
- 团队成员的 skill 版本不一致,因为全局 skill 一般是不需要上传 git,比如:评审流程增加了一个点,我更新了全局 skill ,但是其他同事不知道要更新。
- 新人不知道要装哪些 skill ,比如:有新人加入团队,就不知道公司有特定的安全评审 skill,装的都是通用 skill,评审时漏掉公司特定的检查项。
项目级 skill 能解决什么问题
- 工作流标准化 :团队协作可以统一执行流程,不再是每个人各自理解。
- 隐性知识显性化 :老员工的经验可以沉淀下来,新人也能按标准流程执行。
- 新人快速上手 :git clone 代码就能用,也不用额外配置,不用看一堆文档了。
2.2.3 SKILL 推荐
我有时候需要一些 AI 扩展能力的时候,发现让 AI 搓一个比较耗费时间和 token,网络上找半天又不知道哪个比较好用。
因此建立这个文档,欢迎大家在下面留下觉得好用的 Skill / MCP,我会基于实用性和评价更新进文档里面。废话少说,我先列一些我个人觉得还不错的 Skill / MCP。
2026-07-07 新增 “学术 / 科研” 大类以及补充若干工具推荐
2026-07-06…
2.2.4 建议
- 不要为了用二用,说不定现在团队根本就不需要项目级 skill ,个人 skill 就能一把梭了。
- 先观察团队在协作中到底哪些事情是真的重复、真的比较麻烦的,再去着手写 skill。
- skill 要持续维护,有问题要及时反馈,用的人多了,反馈多了,它才会越来越贴合团队的实际需求。
2.3 MCP
2.3.1 是什么MCP
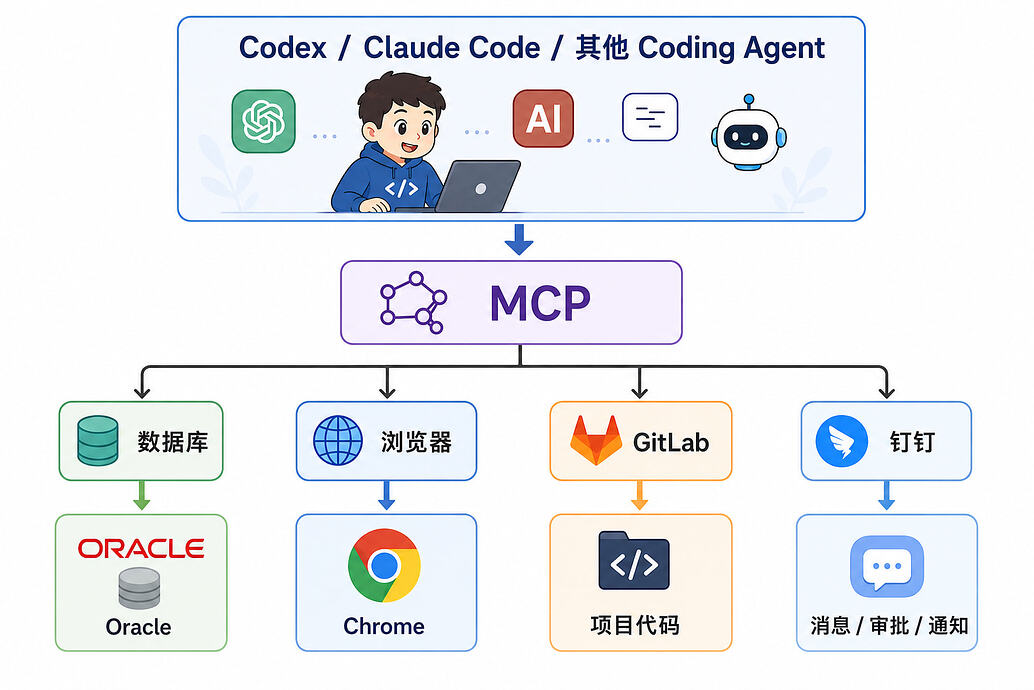
MCP 全称 Model Context Protocol(模型上下文协议),是 A\ 提出的一套开放协议。
简单理解:
MCP 就像 AI 世界的 USB 接口,让 AI 可以用统一的方式连接外部工具和数据。
如果没有 MCP,不同 AI 工具想连接数据库、浏览器、GitLab、钉钉等系统,往往需要分别开发不同的集成方式。
有了 MCP:
第三章:AI 编程的三种开发模式
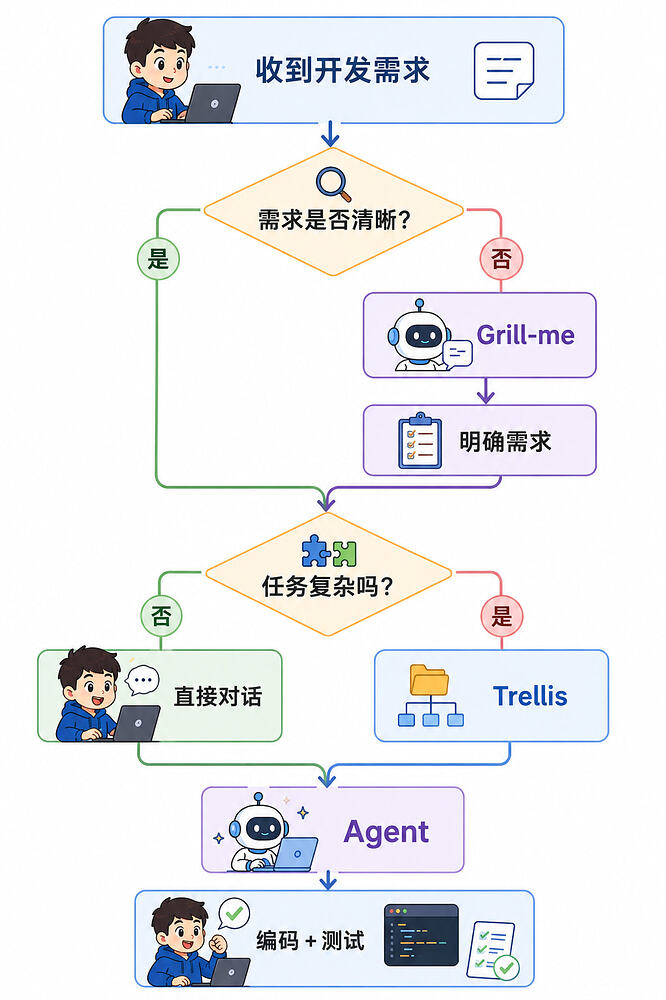
3.1 小需求:直接对话
任务很明确,小功能,直接开干
案例演示
3.2 不确定需求:Grill-me
- 我不太清楚系统的相关逻辑,不知道从何入手
- 完全不知道该怎么去实现某个离谱需求,懵逼状态
安装 Skill
- 命令行输入:
npx skills@latest add mattpocock/skills - 空格选择 grill-me、grilling,选择对应的编程工具
案例演示
3.3 复杂需求怎么办?
- 需求非常复杂,一次对话下来任务没完成多少,倒是压缩了好几次,上下文直接烂完了
- 明明在 AGENTS.md 中写了规范,但他就是不遵守
- 项目干到一半,被临时抽调到其他项目;其他同事接手,一脸问号:???
- 任务还没做完,上下文也满了,准备下班明天再干,明天新开会话,又得重新再跟 AI 说一遍,烦死了
- 团队里用什么编程工具的都有,Codex、Claude code、Trae、Cursor,他们每一个规范配置都不一样,没法统一
- 开发过程中的经验和踩坑都分散在聊天对话中,任务完成以后能不能自动帮我们沉淀规范,省的我们人工去补充完善
我们带着这些问题继续往下看⬇️
第四章:AI 编程工作流:Trellis
4.1 Trellis是什么
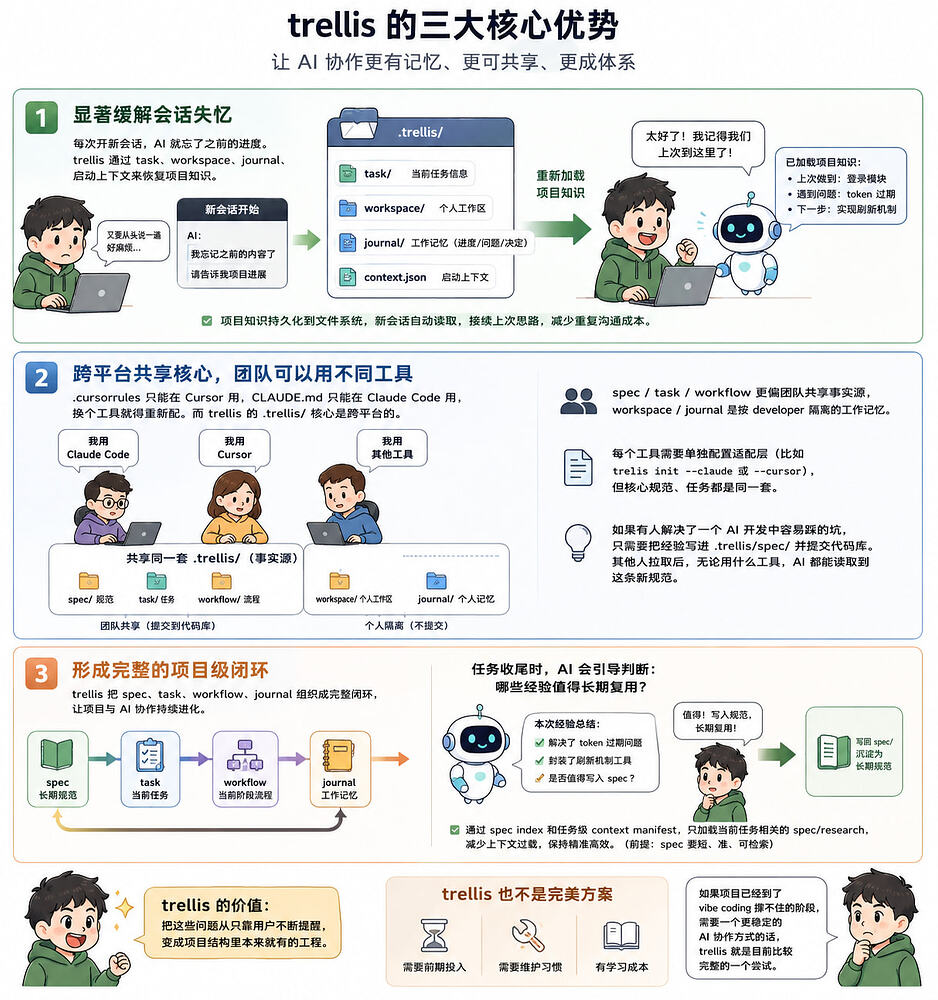
AI 编程脚手架,把项目规范、任务进度、工作记忆、经验沉淀,从临时对话搬到项目下的文件中。它解决的核心问题不是“AI 会不会写代码”,而是“怎么让 AI 在复杂项目里,长期、稳定、按照项目规范完成开发任务”。
三大优势:
显著缓解会话失忆:它可以把任务当前的进展状况记录在日志里,新会话启动,自动从日志中恢复当前的任务记忆
跨平台共享核心:
.cursorrules只能在 cursor 用,CLAUDE.md只能在 claude code 用,但.trellis/核心是跨平台的,支持各种编程工具形成完整的项目级闭环:把 spec、task、workflow、journal 组织成完整闭环,比如:
- spec 管长期规范
- task 管当前任务
- workflow 管当前阶段
- journal 管工作记忆
- 任务收尾的时候,ai 会引导我们判断哪些经验值得长期复用,再把稳定规则写回 spec 里面
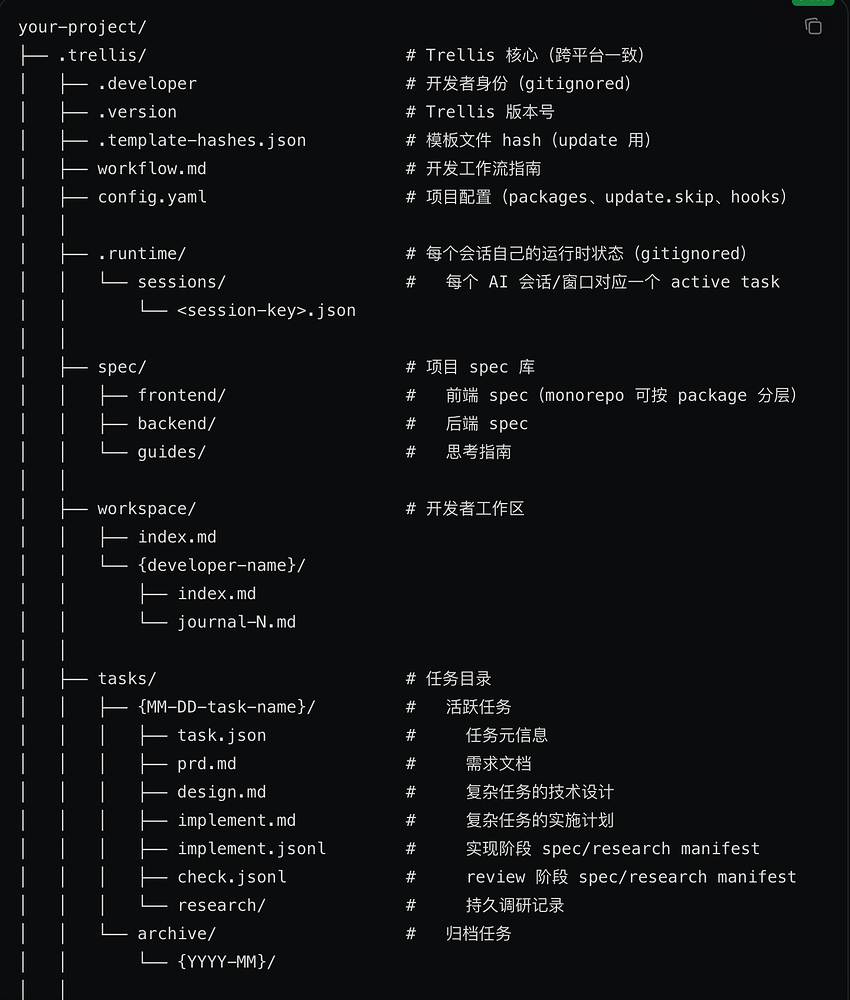
4.2 核心结构
Trellis 的核心结构在项目根目录的 .trellis/ 文件夹中。它取代了传统的单体规则文件,拆分为三个维度:
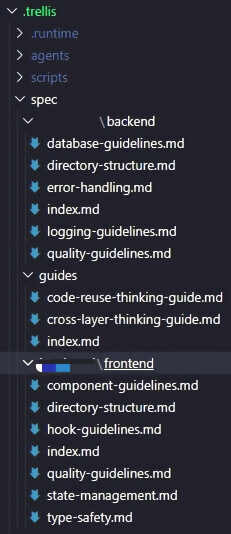
.trellis/spec/(规范层)
用于存放 Markdown 格式的编码标准、目录结构规则、评审习惯等。Trellis 的机制是按需加载,它只会向 AI 注入与当前任务相关的规范,而不是一次性塞入所有内容。
.trellis/tasks/(任务层)
存放结构化的 prd(需求文档)、design(设计文档)、implement(实现计划)以及当前任务信息。这能确保 AI 的产出始终紧扣业务目标,不偏离任务轨道。
.trellis/workspace/(记忆与工作区)
这是解决“会话失忆”的核心。这里存放工作日志(Journals)。它会记录上一次会话执行了什么、发现了什么 Bug、下一步要做什么。每次新会话开始时,AI 会先读取工作区日志,无缝接续上次的思考逻辑。建议上述三部分加入到git,这样整个团队都可以共享。
4.3 工作流程
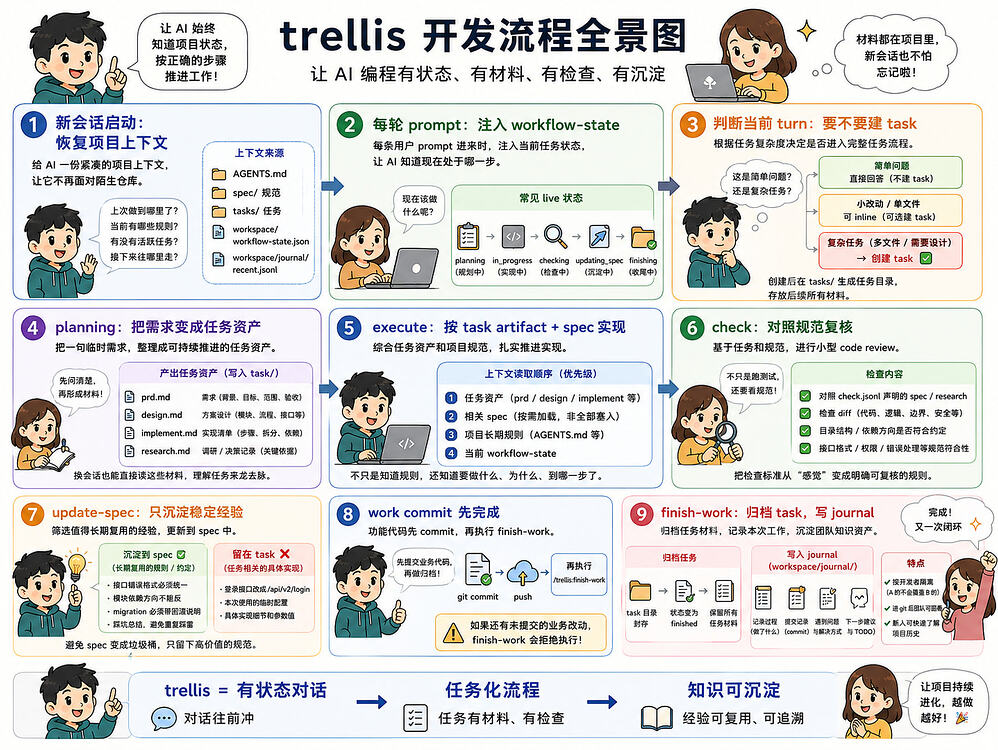
- 新会话启动时,先恢复项目上下文
- 每轮 prompt 注入 workflow-state
- 判断当前对话是否需要创建 task
- planning 阶段把需求整理成 task artifact
- execute 阶段按 task artifact + spec 实现
- check 阶段按任务和规范复核
- update-spec 阶段筛选稳定经验
- work commit 先完成
- finish-work 归档 task,写 journal
4.4 团队使用建议
需要进入 git 的有这些:
.trellis/spec/:团队规范,和代码一样走 pr review.trellis/tasks/:任务目录(prd、design、research),是项目资产.trellis/workspace/{name}/:各开发者的 journal,/trellis:finish-work会追加 journal
不需要进入 git 的有这些:
.trellis/.developer:记录当前开发者名,gitignored.trellis/.runtime/:会话运行时状态,gitignored
重要 spec 改动应该在团队里讨论,spec 库要当成团队代码来维护。
这样规范演进是可控的、可追溯的。不会出现某个人私自改了规范,其他人不知道的情况。
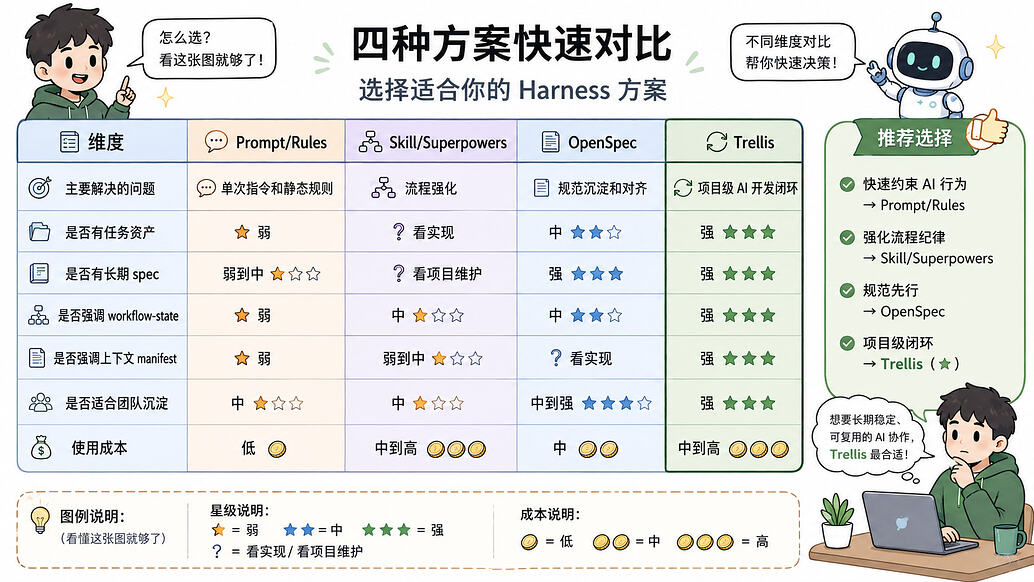
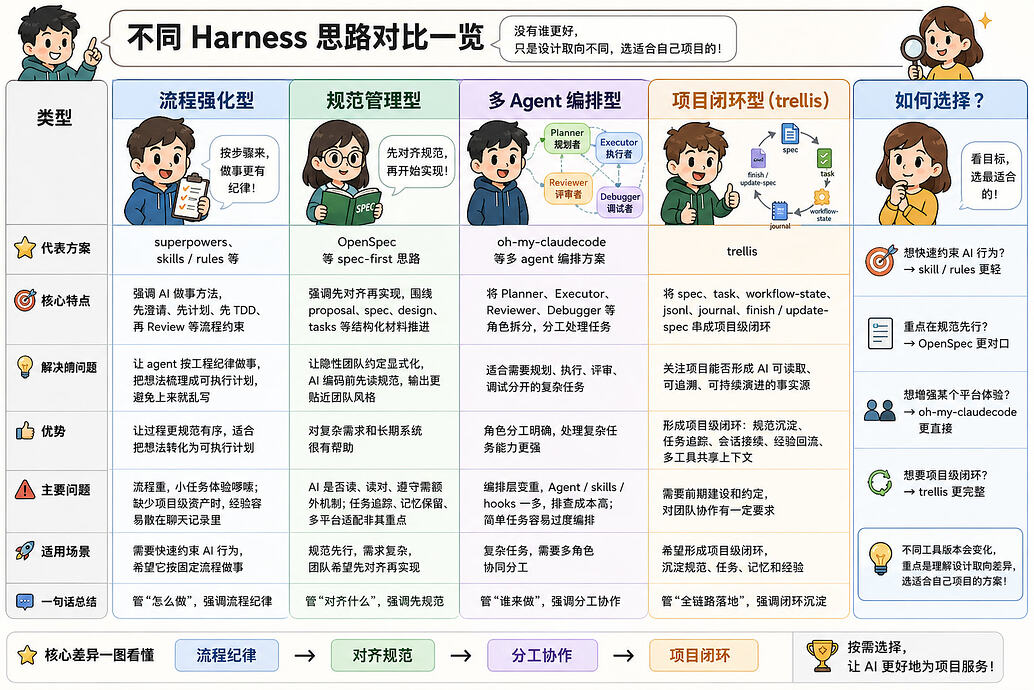
4.5 和其他Harness的区别
4.6 基础使用
初始化
先安装 cli,然后在项目里初始化:
1 | npm install -g @mindfoldhq/trellis@latest |
初始化后会自动生成一个任务:00-bootstrap-guidelines,我们告诉 AI:开始任务:00-bootstrap-guidelines
ai 会从真实代码里提取第一版 spec,任务跑完之后是这样的:
Codex 需要额外开 hook
在 ~/.codex/config.toml 里开启 hook:
1 | [features] |
然后跑一次 /hooks,审批 trellis 安装的 UserPromptSubmit hook。
VS Code 插件的话,Codex settings - hooks
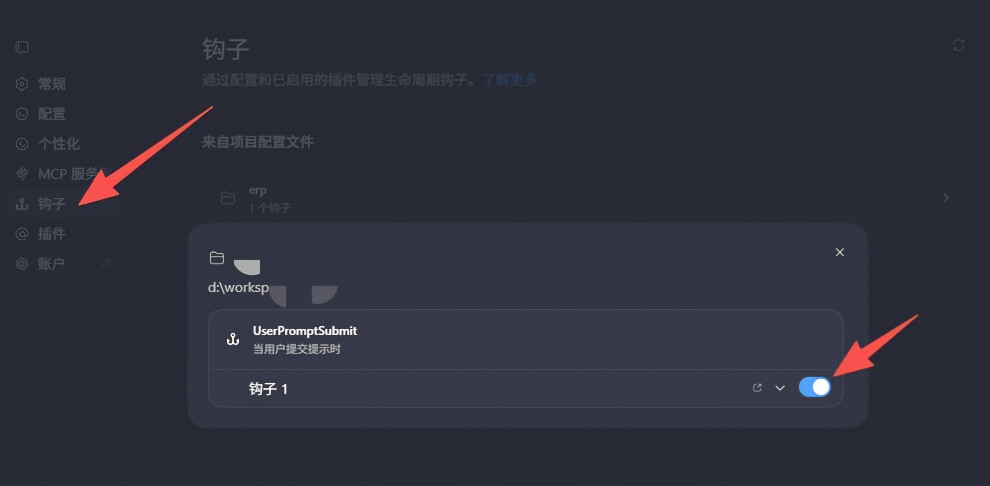
如果 不开的话,/ 菜单里可能看不到 trellis 的命令,workflow-state 也不会自动注入。
其他平台按官方安装文档走就行,不同工具的接入方式会有差异。
日常使用:直接描述任务
直接把你的需求发给它,如果是复杂需求,它可能会自动调用/brainstorm(类似grill-me)帮你对其需求;然后会提示你要不要创建 task,根据你的需求进行回答。后边直接根据它的引导进行回复就行了。
详细内容移步大佬的文章:
从 vibe coding 到 spec coding:我用 Trellis 的实践总结 开发调优
[!tip]本篇是我个人使用 Trellis 的理解和实践总结,仅代表个人观点,如有不对的地方,还请各位大佬指正。非常感谢。
我现在用 ai 写代码很多时候都是一把梭的,也就是说我只需要给 ai 一个要求指令,剩下的就交给 ai了,现在模型能力确实越来越强,有时候我甚至可以不用 superpowers 这种工作流插件都可以做到很规范。所以这种 vibe coding 的写法已经很广泛了,…
4.7 案例演示
4.8 其他
如果感觉Trellis还是很重,可以尝试用 mattpocock/skills 系列的 skill 组合:
grill-me/grill-with-docs(需求聊透) → prototype(可选,快速输出demo,验证可行性) → to-prd(输出方案) → to-issues(任务拆分) → tdd(测试驱动开发)→ diagnose(可选,改bug)
第五章:AI中转站科普
AI 中转站大起底:什么是中转站,倍率是什么
本帖看前说明:
本帖允许转载,但是需要标明原作者
https://linux.do/u/hlool/summary
本帖允许直接中转站链接过来,让用户理解中转站倍率
本帖内的黑灰产仅作介绍,不做实际操作示例展示
“中转站”这个词,在 AI API 圈子里已经存在很久了。
基本上很多人都知道这个名词,但是由于技术门槛、部署成本,或者其他原因,并没有真正自己部署过,所以对其中很多细节并不清楚。
这个词意味着风雨同舟
风雨同舟
意味着 any,也意味着各种各样的翻车或者良心。
今天带大家了解一下中转的运行方式、成本、倍率,以及一些常见的风险判断方式。
中转站常见程序
目前中转站一般使用几类程序:
newapisub2apiCPA
其中 newapi 是从 oneapi 延伸出来的项目。
它的主要作用,是将你的 API 通过中转的方式分发出去。
例如,你有渠道,可以通过美元向 OpenAI 购买 API,然后把它中转给用户使用。用户使用的时候,会受到后台规则约束。你可以给他们设置额度、倍率、可使用模型等。
所以这个程序的主要作用就是分发。
sub2api 是在订阅上进行分发的程序。虽然 newapi 也有类似能力,但这不是 newapi 的重点。
它更侧重于怎么把订阅分享出来。
订阅可以理解成 AI 厂家开的自助餐;而订阅分发,就是你在店里下了团购,然后站在店门口,把饭端出去分给外面的人吃。
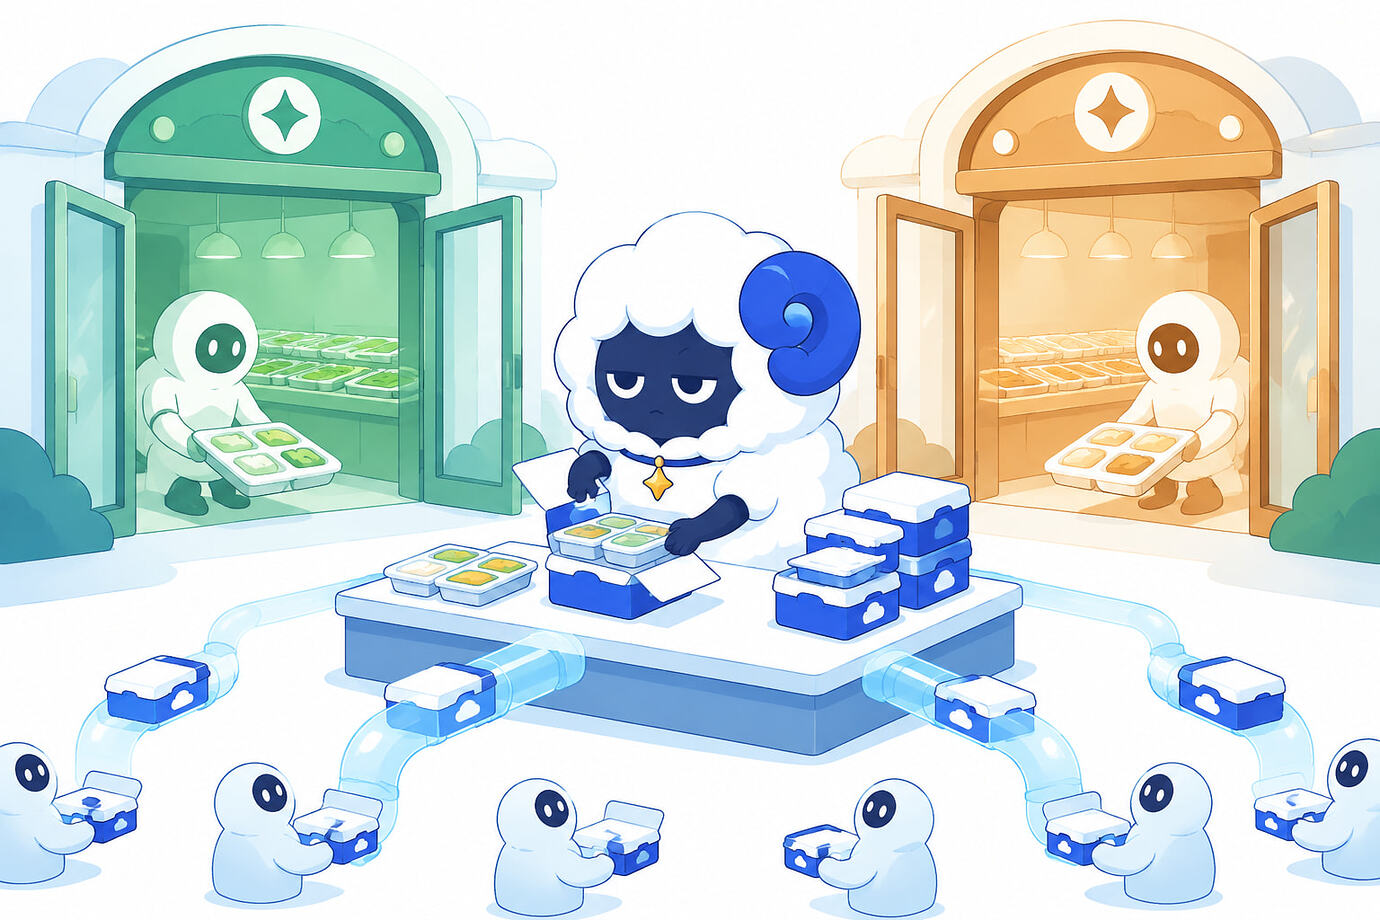
所以 sub2api 的主要作用,是分发订阅,同时做防封号以及其他相关操作。
CPA 全名 CLI Proxy API。
它和 sub2api 一样,也是从订阅拿号,但更侧重于从 CLI,也就是终端程序中获得订阅能力再进行分发。
它的分发属性比较低,更像是自用的订阅中转程序,并且没有计费之类的项目,一般用于拼车以及其他操作。
市面上基本上大部分中转都是类似结构。即使有自建程序,也多是在这些项目的基础上拓展延伸,或者改动 UI 和功能。
基本结构一般是:
1 | newapi 分发 -- CPA / sub2api 上游 |
中转站的网络和服务器
说完中转站用的程序,现在来说中转站用的网络以及服务器。
目前中转站中,小型站点一般使用 VPS 服务器。可以通过 ping 来大概判断它使用的网络。
常见方案主要有:
CF,也就是 Cloudflare,作为网络 CDN 加速。有技术能力的站点,会套上优选 IP 给亚太地区加速。
- 亚太 CDN,很多小厂会做亚太 CDN 加速,基本上是日本和香港节点,对国内分发速度比较快。
- 备案后的国内 CDN,比如腾讯 EdgeOne,或者阿里类似的动态加速服务。这些 CDN 支持动态加速,但是需要国内备案,风险更高,所以大部分服务商不会提供。
VPS 常见的有 RackNerd。以前美西机房比较稳定,比较适合建站。除此之外,还有很多其他小厂和不同线路的服务器。
这些一般都是小玩家使用的,价格通常在一年 500 元左右,基本低于 1000 元。
用量大的站点,一般会开 OVH 的独服,或者其他独立服务器,追求高带宽,G 口甚至 10G 口。
这类服务器一般价格在一年 4000 元以上,不然配置通常比较一般。
中转的真实成本
说到中转的服务器和网络,接下来就了解一下中转的真实成本。
Claude 我不熟悉,这里主要讲 GPT。
GPT 的订阅中转,如果转换为大家使用的额度付费,一般流程是这样的:
首先,把官网定价直接复制到中转后台。
然后可以设置:
1 | 1 美金 = 多少平台币 |
大部分设置的是:
1 | 1 美金 = 1 人民币 |
这样方便计算。
但是很多站会设置成:
1 | 充 7 元 = 1 美元 |
诸如此类。
除非这个站是真实用美元直接购买官方 API,否则订阅站本身并不需要这样计算。
这是一个倍率陷阱。
随后,就是用户使用时的倍率分组。
倍率分组就是用来计算真实价格的分组。
例如输入 5 元,给你倍率 0.1,那么实际就是:
1 | 5 * 0.1 = 0.5 元 |
在前面 1 人民币 = 1 美元 的时候,其实已经做了约等于 1/7 的折扣。
到了这里,就是进一步的折扣计算。
订阅号的额度计算
这个倍率一般是怎么给的呢?
这就要讲到订阅号的获取。
真实订阅价格和真实额度,大家可以参考 Codex 雷达。
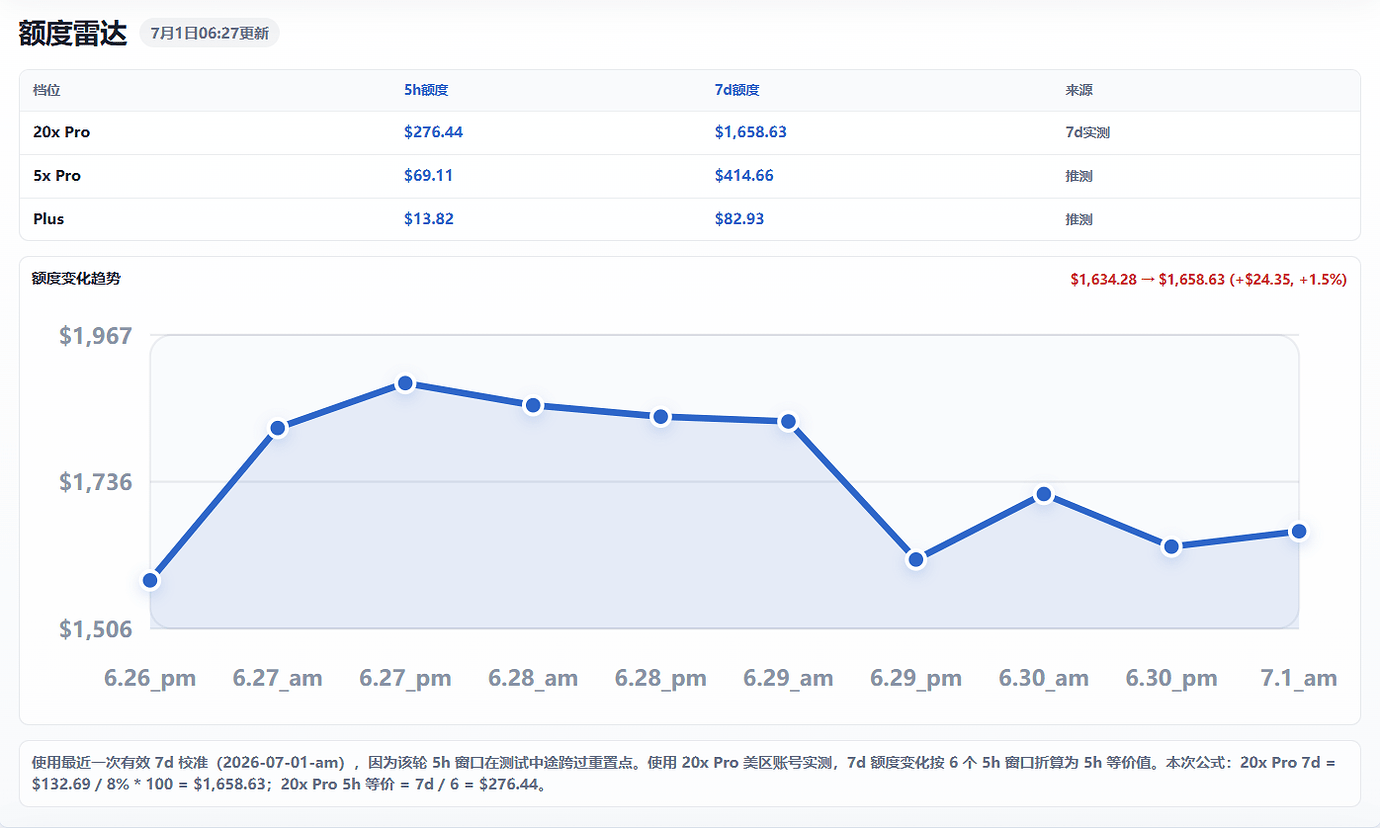
根据图中可以得知,每个 20x Pro 的号,一周满额度一般是 1600+。
但是之前 Pro 的额度约为 2500+。
OAI 后来降低了不少额度。
现在这个额度,乘以 4,就是中转正常获取的额度:
1 | 1600 * 4 = 6400 |
在过程中,一般会有 1-2 次重置,也就是额度差不多在:
1 | 1600 * 6 = 9600 |
也就是大概 10000 刀。
整体来看,一个号大概能跑出:
1 | 6000 - 10000 刀 |
但是只需要 200 美元左右即可撬动。
因为中转站给用户计算时通常按人民币算,也就是成本大概 1400 元,卖出的是 6000-10000 元口径的额度。
这时候,如果它的倍率是 0.1,那么:
1 | 6000 * 0.1 = 600 |
一个号卖完反而还会亏钱。
1 | 1400/6000=0.23 1400/10000=0.14 |
所以现在的中转价格,抛去废号成本,一般 Pro 号倍率会定在 0.2 左右,其他渠道倍率在 0.1 - 0.2 之间。
订阅号是怎么换算成“额度”的
这里很多人容易混淆:200 美元不是买了 1600 美元的官方 API 余额。
更准确地说,是这样的:
Pro 订阅本身的真实成本大约是 200 美元/月,折合人民币大概 1400 元。
但是 Pro 订阅不是按 API 余额计费,而是按订阅制给你一定的使用量。中转站会把这个使用量拿来跑模型,然后按照 OpenAI 官方 API 的价格反推:
如果这些请求不用订阅号,而是直接走官方 API,大概要花多少钱?
假设一个 Pro 号一周能跑出相当于 1600 美元官方 API 价格 的用量,那么这个 1600 美元并不是现金,而是“按官方 API 标价折算出来的额度”。
中转站后台通常又会把:
1 | 1 美元额度 = 1 元人民币额度 |
这样记账。
所以一周的折算关系就变成:
1 | Pro 订阅真实成本:约 1400 元/月 |
一个月按 4 周算:
1 | 1600 * 4 = 6400 |
也就是说,一个成本约 1400 元/月 的 Pro 订阅号,如果稳定跑满,一个月大约可以榨出 6400 元口径的平台额度。
这里的核心差价就在于:
1 | 真实成本:1400 元 |
但这还不是最终利润,因为中转站通常还会给用户设置倍率。
比如倍率是 0.2,用户实际消耗就是:
1 | 6400 * 0.2 = 1280 元 |
这时候,一个 Pro 号如果只跑出 6400 元口径额度,卖 0.2 倍率反而可能接近亏本。只有当账号出现重置、跑出更多额度,或者账号成本更低时,才有利润空间。
所以看中转价格时,不能只看“官方 API 标价额度”,还要看三件事:
1 | 订阅真实成本 |
这三层分清楚,才能看懂为什么有些站倍率能做到 0.1、0.2,也能看懂为什么太低的价格往往意味着渠道风险更高。
除了 Pro 号,还有什么渠道
那么除了 Pro 号之外,这些渠道都是什么?
为什么可以这么便宜,甚至之前能做到 0.01?
这些就是传说中的:
- Bug Team
- 首月 Plus
- 黑冲
- 逆向
- 黑灰产
Bug Team
Bug Team 指的是 OAI 企业订阅里偶发性的 bug。
例如之前,只要 0.52 美元就可以开企业账户,然后通过分发获取接近 Plus 的额度。
那段时间出现过很多公益站。
这种渠道一般不会长期存在,主要取决于平台什么时候发现并修复。
首月 Plus
首月 Plus,指的是 OAI 会给不同地区的用户首月优惠。
只需要提供支付方式,就可以开通账号。
这个方式包括:
- 虚拟卡台,基本没了
- 欧洲支付,目前健在
- PayPal 支付,基本半死
- GoPay,基本没了
- 巴西 Pix,基本没了
- 其他各种地区支付方式
可以说,只要 OAI 还有优惠,就会有人想办法获取。
这个方式一般也有 K12 等未说明的渠道。
黑冲
黑冲原本指的是海外盗用信用卡消费、盗用礼品卡消费,甚至有一些是黑产渠道直销。
现在大多数指的是 Google 等第三方支付平台。
原理是用户用这些支付平台付费给 OAI,然后向平台反馈说“我被盗了,帮我追回”。
平台追回后,OAI 那边还要 1-3 天左右才能同步知道。
这时候会员还在,中转站可能已经刷完了一个周限 2500 刀。
如果有重置,就可能刷完 5000 刀。
逆向
逆向指的是通过第三方支持流式输出的平台,或者不支持的平台,例如 Kiro、第三方 IDE 或其他产品。
通过获取它们与 OAI 不同的接口,自己写注册和转发逻辑,然后把这些产品拿过来给用户使用。
这种接口做对话 OK,coding 不 OK。
现在一般是 image2 的 1K 使用这个方式,或者一些公益站会使用。
黑灰产
其实上面这些很多都已经属于灰色渠道。
但这里说的黑灰产,是更恶劣、更没有底线的方式。
如果说上面的方式还可以说是利用规则漏洞,那么这种就是直接损害他人利益。
第一种,盗用 key。
在 GitHub、各大社群,通过各种方式,比如搜索 key、诱导新手发送 key、发送免费公益站截留数据,甚至渗透盗用其他 key。
第二种,盗用余额。
oneapi、newapi、sub2api 等程序,很多是非商业用户自己部署的。
他们对公网部署不熟悉,使用通用密码,或者开放了注册和赠金、邀请赠金,就会被利用。
有的是开放注册和有赠金,或者邀请赠金,被批量注册偷取。
第三种,论坛脚本。
在论坛以及其他社区,部署监控脚本。
只要出现公益站、免费 key、用不完的分享 key,这些 key 一经发布,就会被监控到,并且被利用。
便宜渠道的风险
中转站的便宜渠道一般就来自于上面这些。
一般可以做到 0.04 - 0.1 区间。
这些渠道往往会有以下风险。
1. 缓存额外价格
因为你可能现在发了一堆消息给 A 号,然后在下一次对话的时候是 B 号承接。
如果 A 号被封了,就会导致缓存无法继续命中,实际成本提高。
2. 被二次利用
因为他们接入的上游并不是中转自己,可能是别人的号。
别人发现被盗用后,可能会开启截留数据。
甚至这个上游本来就是为了数据做的蜜罐,而你就是被坑骗的用户。
3. 降智
逆向会附带 IDE,也就是程序本身自带的上下文。
这会导致上下文被重复覆盖,最终表现变差。
4. 被替换模型、掺水
因为低价,所以很多人不会认真核验。
掺 Mimo 都算好的。
不过豆包模型很多时候比 OAI 这类渠道还贵,所以一般不会有人掺豆包,会亏钱。
以上就是本次分享的中转站大起底内容。
欢迎大家指正,不是很理解举报的原因。
下次有空,再继续科普。
中转站百科第二集:怎么上手开一个中转站?
中转站百科第一集:什么是中转站,倍率是什么(科普贴) 开发调优
AI 中转站大起底:什么是中转站,倍率是什么
本帖看前说明:
[ai-relay-h-batch-a-001-01-use-case-stylized-concept.-asset-type-wide-horiz]
“中转站”这个词,在 AI API 圈子里已经存在很久了。
基本上很多人都知道这个名词,但是由于技术门槛、部署成本,或者其他原因,并没有真正自己部署过,所以对其中很多细节并不清…
前提回看
上一期,我们讲了关于中转站的一些介绍
这一期,我们来指明一些实际的操作
近期论坛里面的帖子已经到了很离谱的程度了,全都是:我想开中转,怎么做/公司想开,怎么做/中转选哪里服务器啊什么的巴拉拉的
很多佬也会私聊我咨询一些问题,今天来进一步的指出一些方案
第一步,确认自己的需求:我想做中转,不确定是否要做
首先质问一下自己:
你是否有需求做中转?
做中转的话,无非有两种需求:
- 想要做中转,把自己的订阅分发出去。找到了便宜的渠道,想要做公益站,或者分给自己的朋友去使用。
2.想赚钱,开商业站,加州风味加点发大财,
如果你自用量大,可以买官方订阅,实际上封号概率也没有传说中的那么大,破限之类的操作去中转做就好了。
如果你自用量小,想要分给朋友之类的一起用,直接发中转让朋友用就好了!你介入进去有因果的!
警惕自己的订阅中转出来给大家用,因为这封号很难受的。
如果你想要做的是商业站,就继续向下看我后面的帖子
第二步,确定要做了:号池从哪来?我怎么成上游了?
中转的上游从哪里来?
自建号池,以及纯上游(AI HUB这种)
纯上游这种,你要面对的就是,上游的不确定性,用户吃到屎了你要怎么解决,以及稳定性之类的,自己无法把控,并且上游叠加你这边一手,不一定价格优惠的情况下,还会增加一手延迟。(价格特别低的上游万一是投毒的你不炸了)
自建号池,你要面对的就是,现在号源少,基本都是正价号,你要做好防封禁的准备,避免账号被封禁,又要让用户用起来不那么难受。现在又多了luna等难受的模型,不赚钱,占用订阅并发,并发大了封号,并发小了挨骂,不上挨骂,上了卡了挨骂。
也可以先接上游,自己慢慢摸索渠道,等到自己摸索通了一条路了,那么恭喜你,你是上游了。
第三步,我要买什么服务器?怎么挑选服务器?
如果你是自建号池,就去美东美西,ovh 无脑入
之所以选择美东或者美西节点,是因为根据这几年美国那边 AI 的相关政策来看,很有可能以后先进一些的 AI 会在本土先发布,然后才允许外国接入。而且这个接入可能没有那么快,特别是从最近老不靠谱的状态来看,服务器在美国应该比其他节点好一些。
当然,如果你打算做纯接上游,也可以直接把服务器放在香港,因为香港接入国内用户还是比较快的。
关于服务器的选择,需要注意以下几点:
- 性能配置:
中转站的程序并发比较高,一般主要消耗单核性能。因此,不一定需要买核心数很高的服务器,因为可能不会有那么多核心同时被利用上。目前的程序优化上,多核不一定有单核性能好的优化。 - 带宽吞吐:
如果你要做很大的站,就要考虑带宽的吞吐量最好大一些。毕竟并发很高,如果输入输出的带宽有问题,会比较难受。 - 厂商与流量:
建议选择大厂。做中转不要选择那种需要买流量的服务器,万一做大了,流量够用吗?
最后就是你硬盘别挑那种石头盘。容易死机。
如果只是建一个很小的中转,可能就几个人用,你可以直接去买阿里巴巴 68 元的新加坡服务器,或者买一些便宜的海外机子都可以。
但在购买之前,最好去查询一下商家的相关口碑,以及所谓的线路优化。其实对于中转服务器来说,我感觉对线路优化不是特别吃重,主要看这个服务器能不能用来建站,以及访问的稳定性够不够强。因为最后都会套上 CF 或其他的 CDN,所以对线路没有百分之百的要求,比如 CN2 之类的,倒是不一定。如果是自用,或者给朋友等小规模使用,买 VPS 就绰绰有余了。
如果你确定需要商业化,最好还是用独立服务器,而不是用 VPS。因为 VPS 在前期或后期并发稍微高一些,可能就会直接开炸。
大家参考一下,像 6 核 8G 的 RN VPS,大概可以吃 400 RPM 左右,这是比较舒服的状态。如果超过这个数字,就容易崩溃;如果少于这个数字,那就非常流畅。标准就在这里了。
像 16h 和 32G 的机子,如果单核性能不强的话,大概可以吃到 2000 RPM 左右。这是独立服务器的状态。
如果是 32h 和 128G,还是 9950X 的话,大概就可以吃到 3 万 RPM 往上走。如果优化好的话,5 万可能都可以吃得到。
更大的我就不知道了,我没做到过啊 face_holding_back_tears
第四步,关于号池的进一步细节讲解。
如果你是选择上游,你现在就到了经典的:没量别人不鸟你,有量找别人,别人接不住。
做着做着发现自己成上游了。
如果你是自建,那么就看下sub2api,codex2api,这些哪个好用做池子就好了
账号开卡,要么U卡,要么卡台(有风险跑了很多家,随用随充吧),要么就是找海外小黑自己开。你不要去找号商开这种全价的订阅,因为实际上号商是有方法可以控制你账号费用退回的。
现在很多号商(也不能说全部,因为也有良心的)会自己“吃一手”。比如从你这边赚了手续费利润后,账号一旦封禁,可能就没有质保或其他保障了,他甚至会主动想办法把你的号封了。这样开号会很难受,正价号就存在这种亏损的风险。
如果说你是自己开,最起码被封号之后,万一能够退回资金,基本上还可以退到你自己的手上。走个退款流程,多多少少把钱退回来还是可以赚一些的。如果这个钱都不退的话,那你就有点难受了。
至于低价渠道,现在越来越少了,很少有很强的号商了,现在开号的方式是蛮多的,但是价格却居高不下,恢复不了曾经的0.01了。可以对比多家的卡网,但是实际上能够上卡网的这些都已经是二道贩子了,很少有真实的号商是用卡网来做的。那种批量的号商,大部分都是直接在 TG 上建群。从他们那边买可能会稍微好一些,但是被骗的概率也还是非常大的。
总之,不是自己亲手去订阅的号,都有可能会炸的风险,大家都要谨慎考虑。如果找了卡台之类的话,那也是需要谨慎、谨慎、再谨慎的,因为近期卡台跑路的情况也有很多。
第五步,获客从哪里来,我要怎么赚大钱?
对于中转站来说,我觉得最好的获客渠道一般是哔哩哔哩、知乎、L站,小红书也算,就是这些社区论坛之类的,因为涉及到的有针对性的群体会比较多。
当然,如果是中转站,就不适合在国内的社区上面发表这些内容,容易出事。但是如果在 L 站之类的平台发表相关内容的话,问题不是非常大。
像你这种用户,就要找针对性的群体:
- 程序员:基本上都是用 coding。
- 设计师:主要是用图片生成和视频生成。
你做中转的话,就要找好自己的获客源在哪里。如果你自己对哪一个群体特别熟悉,就做哪一个群体。
因为其实现在很多中转都做差异化了:
- 我们之前是做低价,渠道透明,赚低价号差价,补一点pro来赚。或者纯靠上游倍率差,AIhub也是这种打法。
- 有的是以订阅的方式,看上去价格会低一些,但是通过一些限制,很难达到完整用完订阅来赚钱。
- 加州的站点,靠风味来赚钱。
- 很高价的站点,有的是坑一波不退费赚钱,有的是真的服务好赚稳定的钱。
- 传说中的nsfw站点,或者全女中转等这种差异化
总之,如果你有自己比较好的获客来源,可能会比较好一些。如果什么获客来源都不清楚,那你不如开个“富可敌国”。
这个帖子发完之后,如果近期多了很多中转,也就是开了很多“富可敌国”,始皇,能不能分我点?
第六步,防止自己的中转站被攻击。
中转站因为同行、友商比较多,开站之后,可能会有纯粹的“脚本哥”想要练手,或者通过攻击你来谋取利润,甚至进行勒索。反正方法是非常多的。
关于程序,如果你使用的是 New API 或 sub 2 API,你们可能就要做好以下准备:程序上线前就套上 CF 或其他 GDR,不要把自己的原站 IP 泄露出来。重要的事情说三遍!
接下来就到了经典的 CF 设置环节。这个东西我也没有办法教你太多,因为教也教不会,只要挨过一次打以后就知道了。
针对于 AI 中转站的 CC 攻击是非常简单的,具体就是以下几个方式:
- 登录节点:可以通过攻击你的登录和注册接口。因为每次登录注册都会对 CPU 造成较大的负荷,攻击者可以通过批量攻击这两个节点,让你的负荷提高。2. API 接口:直接攻击你的 API 接口。在没有带凭证的情况下,一直打这个接口,也会造成服务器的内存虚高。
针对以上情况,可以通过 Cloudflare(CF)进行防护:
(a) 针对登录节点:只要加一个盾就可以了。
(b) 针对 API 接口:需要在 CF 里面单独设置一下,在没有带凭证或者凭证不正确的情况下,会被拦截。
至于数据库泄露之类的七七八八的事情,我这边也不是特别了解。
我基本上在服务器运营上,就是把服务器的相关内容交给fable来帮我进行一轮加固,包括数据库的备份等。
因为像现在这些 AI 的网安,其实做的效果是非常好的。如果是这种正向的反馈,基本上会给你解决,不会把你放到网络滥用里。
第七步,怎么开通自己的收费方式
三方支付大展神通,大家自己找,tg的一定要有大群,国内的也一定要有可以聊天的客户群,不然跑路了就等着哭吧。
自建支付,建议用U之类的
还有跨境支付平台也可以用下,就是费率高很多
还可以类似卖卡的平台,链动之类的,放充值卡密
现在也没有想好还有什么东西要去普及的。
帖子就暂时先写到这里。根据后面有人评论问的问题,我再继续补充,并且继续完善第二集。
5.1 Token为什么能拿来卖
- 每个 AI 账号都有一定量的使用额度,一般都是按5小时、周刷新
- 号商搭建号池,把订阅了编程套餐的账号放到号池里面,这样号池就能共享所有账号的额度
- 每次发给大模型的请求都会有输入、输出Token,并且官方都会有对应的价格,比如:gpt-5.6-sol的输入:$5/100万 tokens、输出:$30/100万 tokens
- 搭建中转站,将号池接入,在中转站充值过的用户就能够使用对应的模型,同时会产生对应的费用
5.2 他们到底有多少利润
中转站一般情况下都是充多少人民币给多少刀,比如我充了100块钱,我在中转站的账户余额就是100刀。
GPT PRO 20x 为例:
参考额度雷达,一个pro账号的周限额大概在1600刀+,之前的时候都能稳定在2000上下。(近期codex额度有问题,乱套了,有高的有低的)
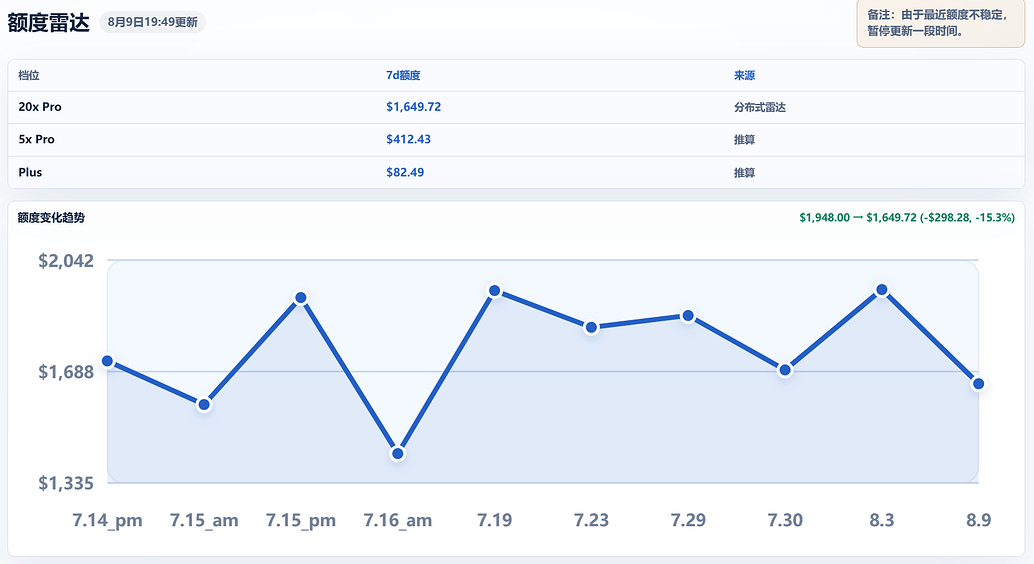
总额度:6000 - 10000 刀
按照1600来算,1个月就是 1600 * 4 = 6400,但是会隔三差五的重置额度,按照每个月重置2次来算:1600 * 6 = 9600,这么算下来,一个号大概能跑出 6000 - 10000 刀
成本:1400 RMB
1个 pro 20x 账号的价格是200刀(美区),我们按照1400RMB来算,也就是拿1400块钱能卖出6000 - 10000元的额度。但是直接按这个价格去卖,太贵了,没人会买,所以出现了倍率这个概念,即消耗额度 * 倍率 = 实际消耗。假如倍率是 0.1、额度是6000,那么 6000 * 0.1 = 600 ,一个号卖完还赔钱了。
倍率:0.14 - 0.23
怎么才能不赔钱呢,1400/6000=0.23 1400/10000=0.14,所以按照6000额度算,0.23不赔钱,按照10000额度算,0.14不赔钱
所以现在中转站的 Pro号池倍率一般会在 0.2 ~ 0.3 左右,其他渠道倍率在 0.05 - 0.2 之间。
5.3 低价渠道都是怎么来的
GPT
- K12:学生邮箱,通过母号无限拉子号,让普通子号也能拥有 plus 的权益。
- Bug Team:之前出现过偶发bug,0.52 美元就能开企业账户,然后通过分发获取接近 Plus 的额度。
- 首月 Plus:OPENAI 会给不同地区的用户首月优惠,通过各种各样的支付方式实现0月支付,paypal、gopay、虚拟卡台、kakao、pix,基本全部拉闸
- 黑冲:信用卡盗刷、盗用礼品卡消费,付费给OPENAI,然后找客服说卡被盗了,但是会有1 - 3天的处理时间,但是这个时候可能好几千刀都刷出去了,但是最后还是会退很多钱,claude 的早期退款流也是大概的原理,只不过那个是被封号后去申诉。
- 逆向:通过技术手段,抓到 Kiro、windsurf 发给大模型的请求,然后模拟请求去调用。
- 黑灰产:国外黑哥们抢来的信用卡,然后低价卖出去速刷;扫全球反代程序的接口,拿到key去盗刷,简单来说就是偷其他中转站的key;最离谱的是缅甸、菲律宾那边的园区,很多都开 AI 中转站了,用诈骗来的U去支付订阅,然后中转卖给用户换来干净的钱,纯纯洗钱最佳方式。
Claude
- 美国初创企业,在AWS有美金扶持,大约 3W
- windsurf ultra,真卡支付,假卡换绑透支,速刷打时间差
- AWS,企业母号无限开子号
- 留学生缴费/跨国转账,赚尾刀利润,搭配尼区礼品卡max 20x能做到6折
- …
5.4 公司AI中转站
为什么要自建中转站:
- 如果想用官方 GPT,还需要翻墙,网络不合规,账号额度也没法共享
- 外边中转站有可能会掺水,卖的是 gpt-5.6-sol ,其实给你的是 doubao;
- 不稳定、速度慢,很多大型的中转站几万个用户同时用,稳定性、响应速度肯定会受影响;
- 降智严重,他们一个号池上千个账号,IP质量可能会非常差;
- 数据隐私:他们能拿到我们所有的上下文,很有可能会拿去卖,现在已经形成了灰色产业链。
基于上述的风险,我决定自己搭建中转站,相比外边的中转站多了许多更加适配公司使用的功能:
- 无需翻墙就能使用纯血的 GPT-5.6、Claude Fable 5(理论上),内网环境也可以用
- 角色:部门管理员,可以维护自己部门的用户信息、调整额度
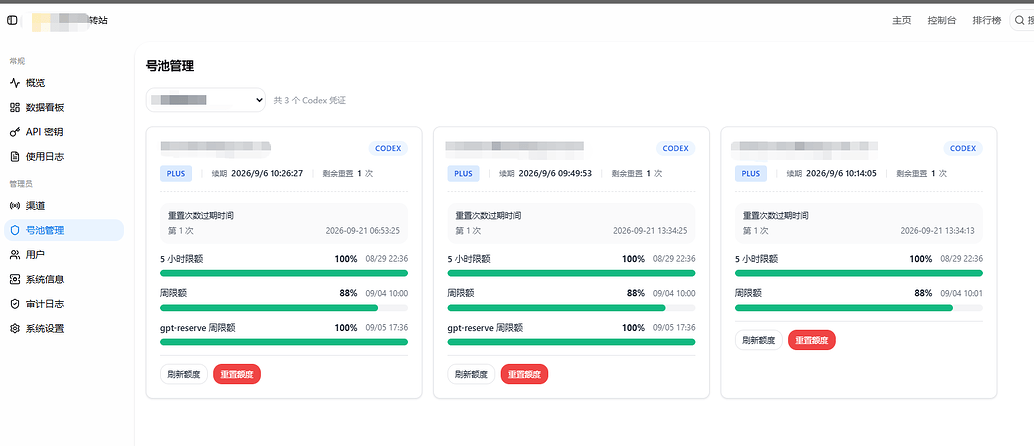
- 可以隔离每个部门的使用环境,每个部门可以维护自己的号池
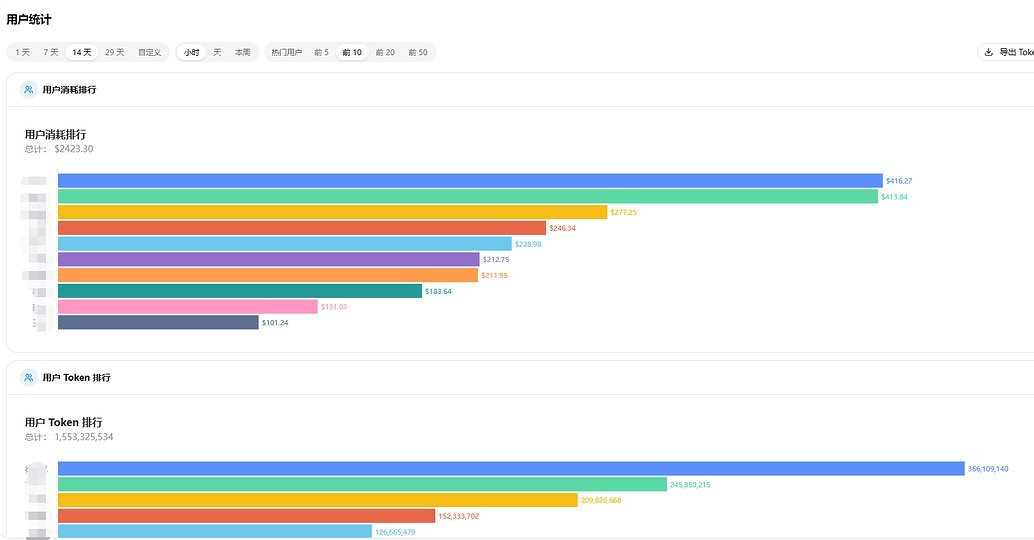
- 一系列关于部门的数据统计,部门用户的金额使用、Token统计等
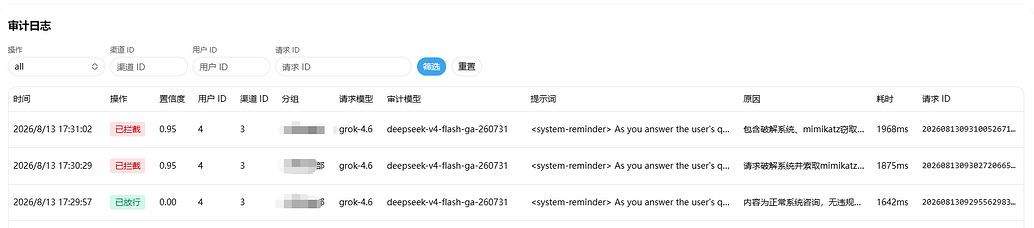
- 安全审计:所有违规(涉及网络安全、逆向、破限)等操作都将会被记录
第六章:AI 编程的边界与风险
AI 可以大幅提高开发效率,但不能替代开发者对结果负责。
边界
- AI 不是万能的,不是一句话就能帮你干完所有,不是所有需求都适合用 AI 来做,有的需求可能用了 AI 反而会降低效率
- AI 不一定真正理解公司的业务,可能会有偏差
- AI 目前没办法完全替代人,只能作为辅助工具去帮助程序员实现需求,这样我们可以拿出更多的时间去补之前的文档、优化系统、架构设计、需求沟通。
风险
- 如果给予AI过大的权限,很有可能会发生不可控的事件,比如:替你执行了一个 rm -rf;DELETE FROM xxx;
- 数据安全和代码泄露,“发给 AI”本质上就是一种数据外发行为,虽然大模型厂商协议里写的不会拿数据用于训练,但是谁信呢。
严格遵守
- 🈲 禁止用GPT模型去做网络安全、逆向、破限等操作 🈲
- AI 生成的代码必须验证
- 敏感数据不要随意提供给 AI
- 高风险操作必须人工确认
- AI 可以写代码,但责任仍然属于开发者
Tip
AI 编程的正确姿势,不是“让 AI 替我负责”,而是“让 AI 帮我完成更多工作,而我对最终结果负责”。
公司AI中转站运营模式
以上就是整个培训的内容,可能有的佬对公司 AI 中转站比较感兴趣,那我就大概说一下我们的运行模式:
一、成本
- 每个部门自己采购账号和VPS,我可以提供渠道和部署,后续账号管理、号池管理都由他们自己部门负责
- 账号:150/月/账号
- VPS:搬瓦工DC6、DMIT Tiny,10-16刀/月
二、架构
- cpa + new-api
- 各个部门采购的VPS部署cpa,设置白名单,只允许公司IP访问
- 公司内部服务器部署new-api,按照VPS的优化线路指定公司出口IP(移动、联通、电信)
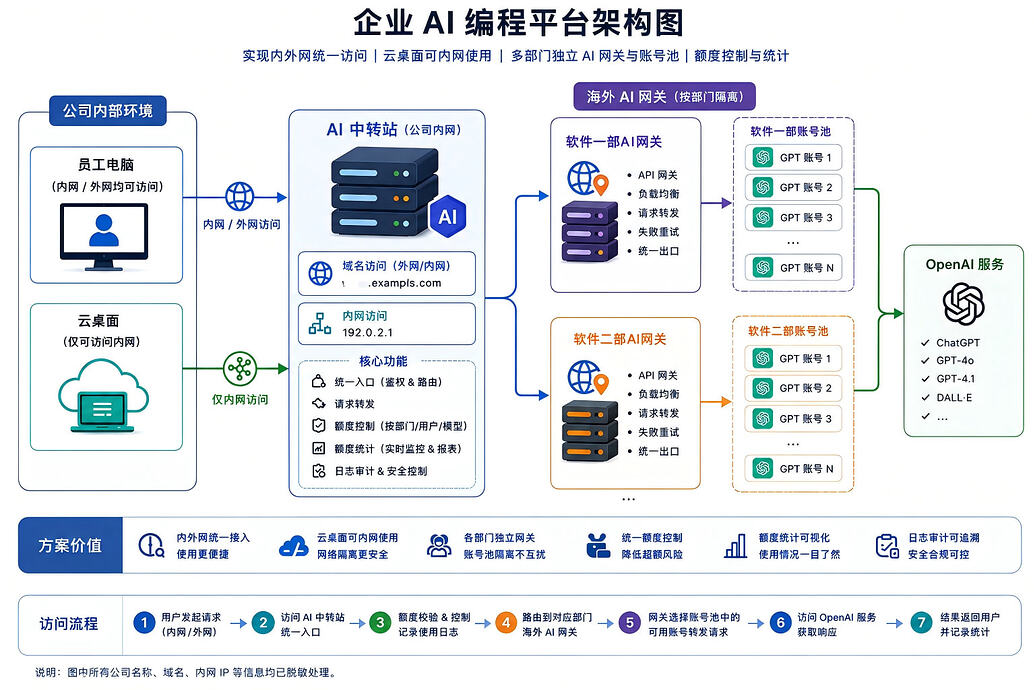
- cpa 二开:
- 指纹修改
- 支持不同账号绑定不同的key
- new-api 二开:
- 提示词审计:防止cyber abuse
- 支持 websocket
- 新增角色:分组管理员,每个部门维护自己部门员工的额度、数据统计分析
- 号池管理:分组管理员可以查看自己部门账号的额度、启用/冻结、重置额度
- 一系列小的功能、数据统计…