易标:AI 标书流水线的工程拆解
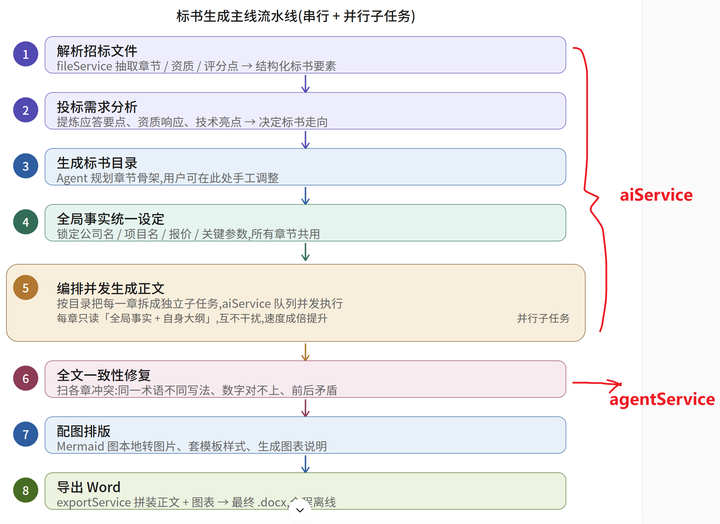
一句话:易标把标书做成可恢复流水线——解析 → 分析 → 目录 → 全局事实 → 编排并发生成 → 一致性修复 → 配图 → Word;知识库与查重 / 废标检查挂在旁路,需要时再接入。
项目描述
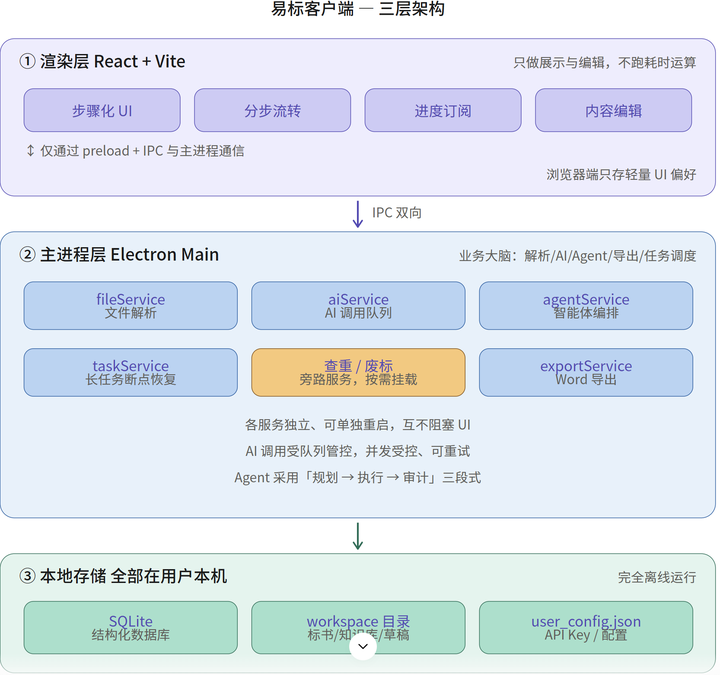
易标是 Electron 本地客户端:React 做步骤化 UI,Main 做解析 / AI / Agent / 导出与 SQLite 工作区。标书能力靠这条可恢复流水线实现;知识库与查重 / 废标是旁路工作区,在需要时挂进生成或检查环节。
渲染层:React + Vite
为什么 React 适合分步流转界面
- 每一步都是独立组件,改某一步页面,不容易打乱其他步骤
- 全局状态统一记录当前阶段、每步填写 / 生成的数据,跳转时数据不丢
- 进度条、上一步 / 下一步、步骤校验(上一步没完成不能跳)实现成本低
Vue 也能做,逻辑差不多;原生 JS 能做,但长链路写到后期很难维护。对长链路、要断点保存、可回退、还会持续加节点的标书流水线,React 是稳妥首选。
Vite 负责搭建、调试、打包最上层 React 界面,并对接 Electron 桌面程序。
渲染层具体干什么
像投标专员面前的操作面板:
- 分步流转:选标书 → 解析 → 目录 → 全局事实 → 正文 → 导出
- 进度订阅:主进程推「目录生成到 40%」「第 12 节写完了」
- 内容编辑:改目录标题、改事实条目、改某节 Markdown
- 触发动作:点按钮发 IPC,例如「开始生成正文」
它不做:解析 PDF、并发调模型、写 SQLite、转 Word。切页也不会取消后台任务——任务在主进程里继续跑。
aiService:通道与结果流水线
aiService 负责排队、调用、重试,把回复变成可用文本 / JSON / 本地图片。
- 提示词:业务 Prompt 在各 Task /
shared/prompts;aiService 固定的主要是 JSON 修复和生图风格后缀 - 其它处理:排队限流、重试超时、多厂商兼容、JSON 抽取 / 修复 / 校验、生图落盘、Token / 日志 / 埋点
它是通道与结果流水线,不是标书业务 Prompt 仓库。
一步里常有很多彼此独立的 AI 请求,所以用 async OpenAI 做并行生成。例如生成正文时,目录和事实已定,第 3 / 7 / 12 章各叶子节可以同时写。
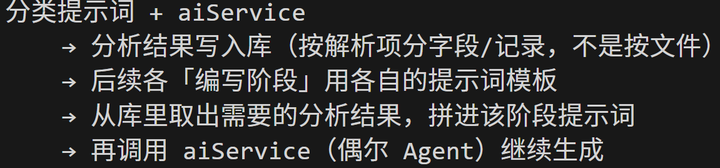
标书所有 AI 分析产出统一落在本地 SQLite;用 Store 台账层封装读写,业务代码不裸写 SQL;通用全局信息会再同步到专属字段,方便多处调取。
Store 台账层
Store = 项目专属数据管家:统一接管存取、安全、台账一致性、格式处理,把业务和底层存储隔开。
举例:用代码拼接 SQL,不用大模型生成 SQL,速度和安全都可控。
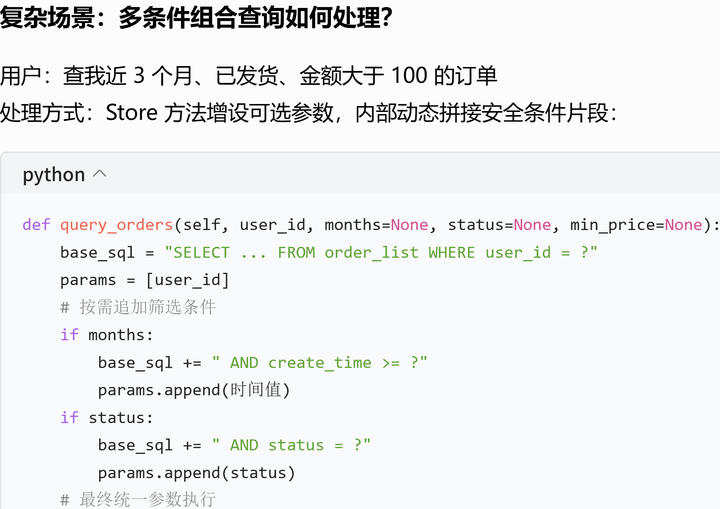
落地靠这几块拼起来:
- Electron IPC 做权限边界隔离
- 主进程按业务拆分多 Store 台账
- SQLite + 文件混合存储
- 上游联动清空缓存、权威数据源、任务互斥写入规则
对应 Store 三层价值:存储边界隔离、业务台账统一管理、数据一致性保障。
AgentService:OpenCode 与 Pi
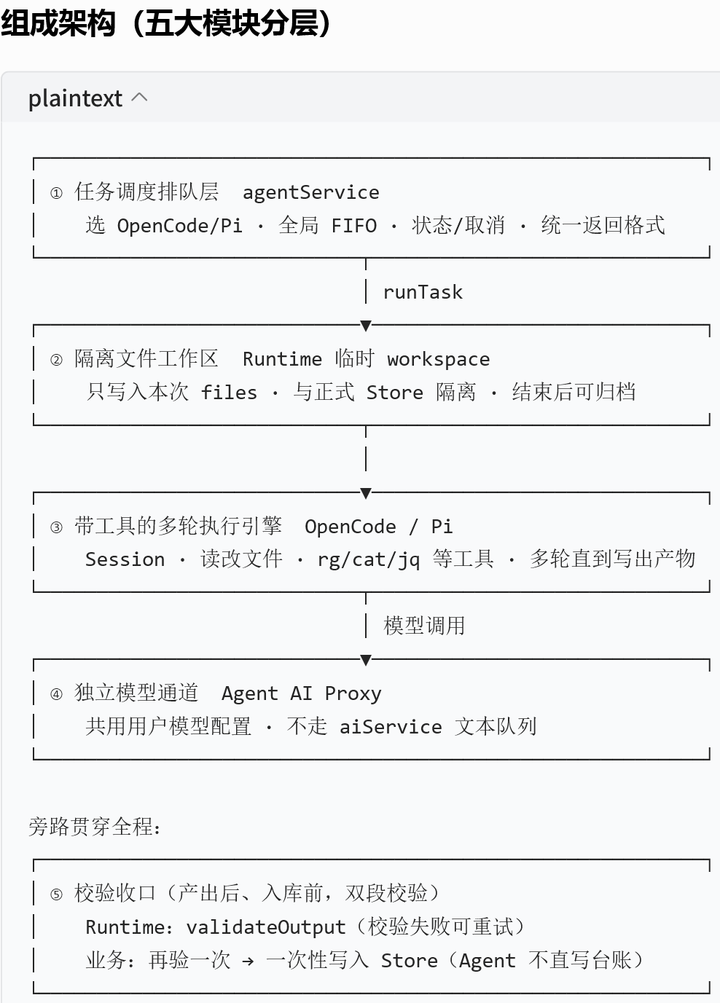
| 项目 | OpenCode(Sidecar 独立进程) | Pi(内嵌 SDK,跑在 Electron 主进程) |
|---|---|---|
| 循环位置 | 独立子进程内部 | Electron 主进程内部 |
| 故障隔离 | Agent 死循环、内存泄漏、崩溃不容易拖垮主软件;主进程可杀掉、重启 sidecar | Agent 出问题会直接污染主进程,严重时整应用卡死闪退 |
| 部署代价 | 较高:要附带 opencode 二进制,管子进程生命周期、端口、中文路径等 | 较低:无额外二进制,打包简单 |
| 性能 | 多一层 HTTP 调用开销 | 无网络转发,链路更短 |
| 沙箱能力 | 自带文件沙箱,限制只能访问 staging 临时目录 | 沙箱要业务层自己约束 |
| 适用场景 | 生产正式环境默认 | 调试、测试、环境受限场景 |
简单「读文件 + 调大模型」demo 很好写;生产级多轮文件 Agent 要处理工具循环、会话、沙箱、死循环、超时取消、故障隔离,工程量很大。OpenCode 把这块做成可调用的 sidecar,项目只需薄适配层 opencodeRuntimeService.cjs。同时自研 Pi 作备选 Runtime,避免强绑第三方。
为什么把它做成 HTTP 服务
OpenCode 在人手里是个终端工具:敲 opencode 进 TUI,打字提问、看回复、再打字,每一步都要人看着、等着。它同时也暴露了一套 HTTP 端口,程序可以在代码里驱动同一套能力。
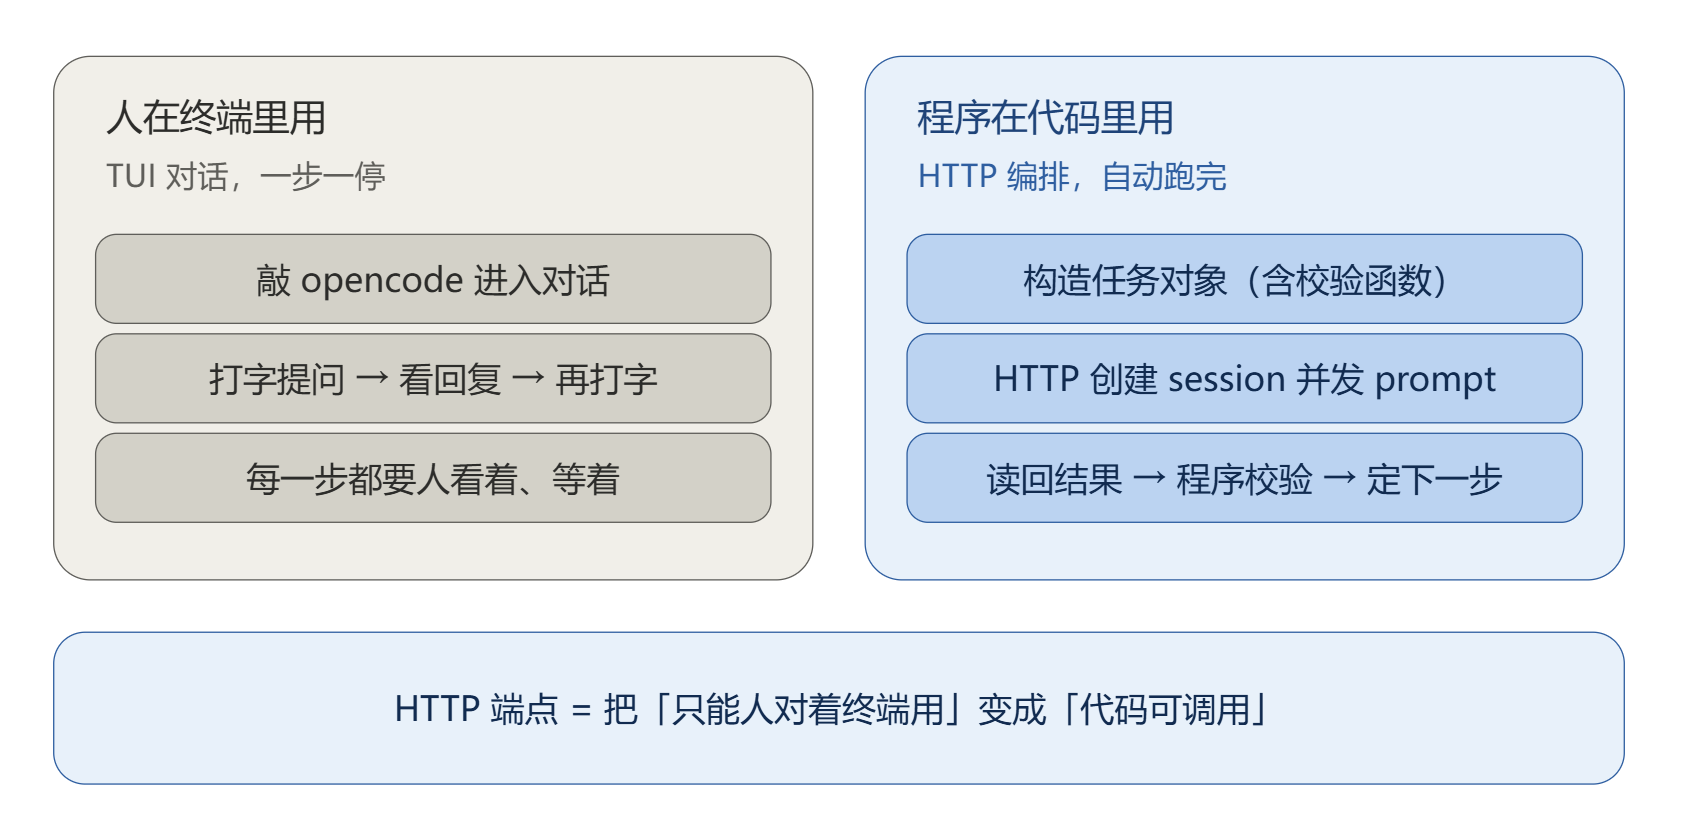
- 构造任务对象(含校验函数)
- HTTP 创建 session 并发 prompt
- 读回结果 → 程序校验 → 定下一步
HTTP 端点这一步的价值,就是把「只能人对着终端用」变成「代码可调用」。易标选 sidecar、不把 Agent 内嵌进 SDK,看中的正是这条服务化链路:主进程用 HTTP 编排,Agent 在独立子进程里跑,出问题能杀掉重启,不污染主软件;代价是多一层 HTTP 开销,换来的是故障隔离和可控的生命周期。
为什么重试修不好真问题
能程序化调用之后,真正的难点落在校验上。模型输出常见的失败分两类:
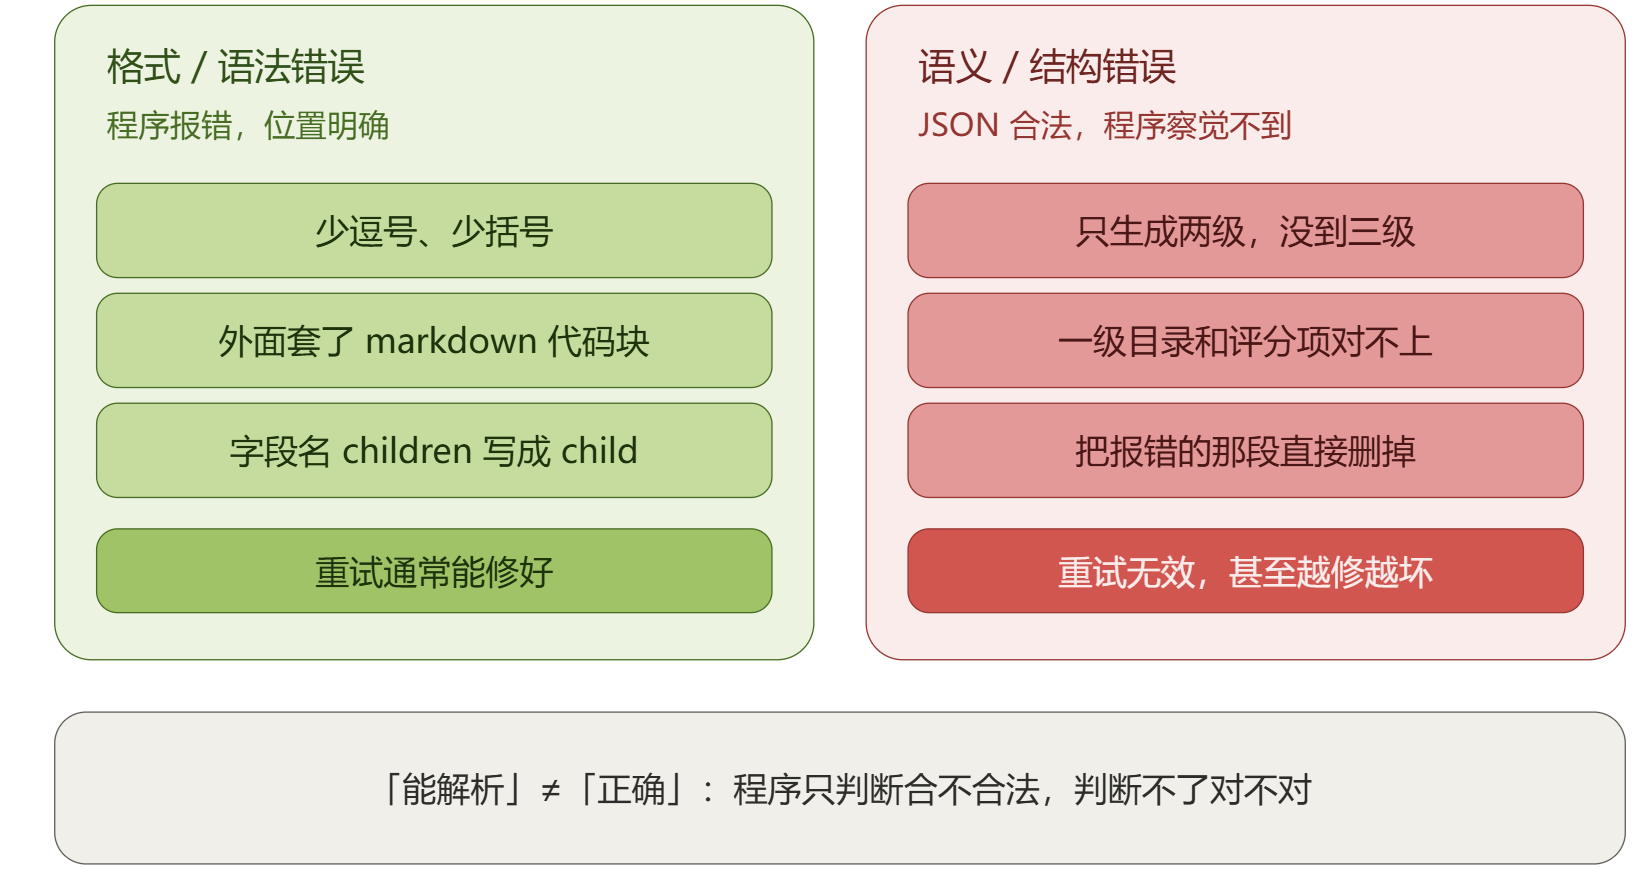
| 类型 | 表现 | 重试有用吗 |
|---|---|---|
| 格式 / 语法错误 | 少逗号、少括号;外面套了一层 markdown 代码块;字段名 children 写成 child |
解析器直接报错、位置明确,重试一般能修好 |
| 语义 / 结构错误 | 只生成两级目录没到三级;一级目录和评分项对不上;把报错的那段直接删掉 | JSON 合法、程序察觉不到,重试无效,甚至越修越坏 |
一句话底线:「能解析」不等于「正确」。程序只判断合不合法,判断不了对不对。所以校验这步不能交给大模型,要由业务提供校验函数,和前文的 normalize / validator 一起卡在 parse 之后。
taskService:长耗时任务的断点续跑
| 层 | 只管什么 | 别让它干什么 |
|---|---|---|
| 任务中心 | 启动、互斥、暂停信号、事件通知、中断后语义 | 不写业务 SQL、不拼 Prompt |
| 持久化 Store | 任务壳 + 业务结果落盘、事务 | 不跑 AI、不管 UI |
| 业务 runner | 真正干活,并在关键点主动落盘 | 不自己维护「全局任务表」 |
其它项目也一样:调度 / 存储 / 业务拆开,断点才好复用。
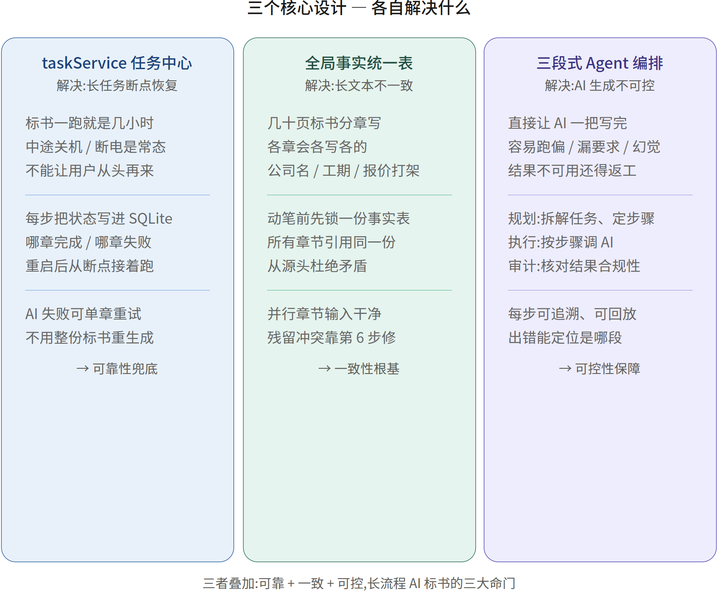
落盘时机(最值钱的一条)
学易标:
- 启动立刻写成
running(不是跑完再记) - 阶段完整结果才写(一节写完、一轮审计完)
- 不要按 token / chunk 流式落半截
- 暂停 / 失败 / 成功都要落最终态
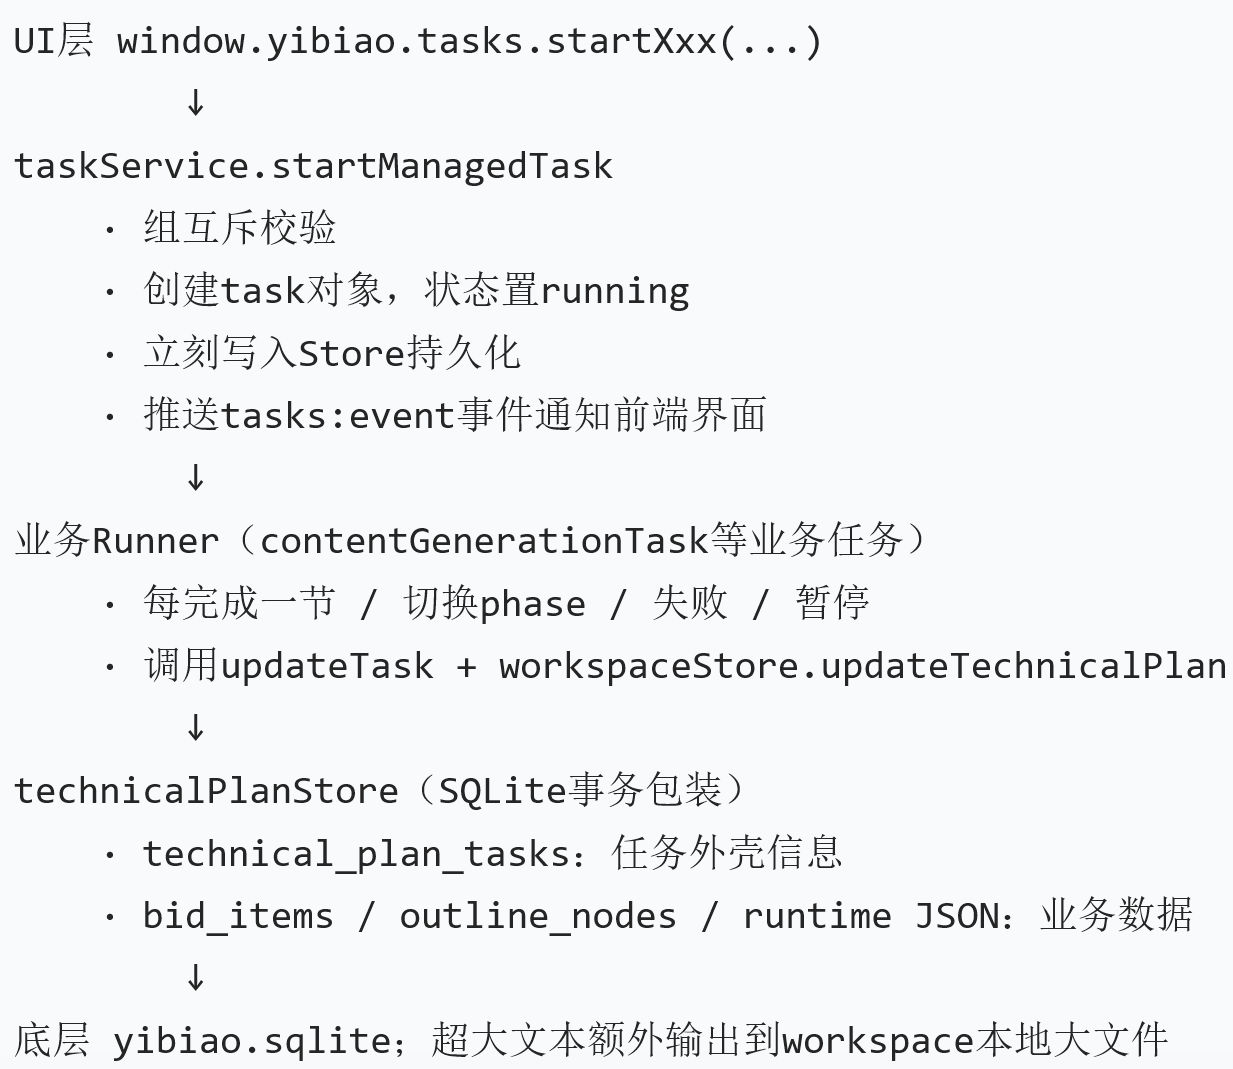
迁移口诀:可恢复的粒度 = 你愿意重做的最小完整单元(一章、一批文件、一个 pipeline step),而不是模型吐出的每一个字。
SQLite + 文件混搭
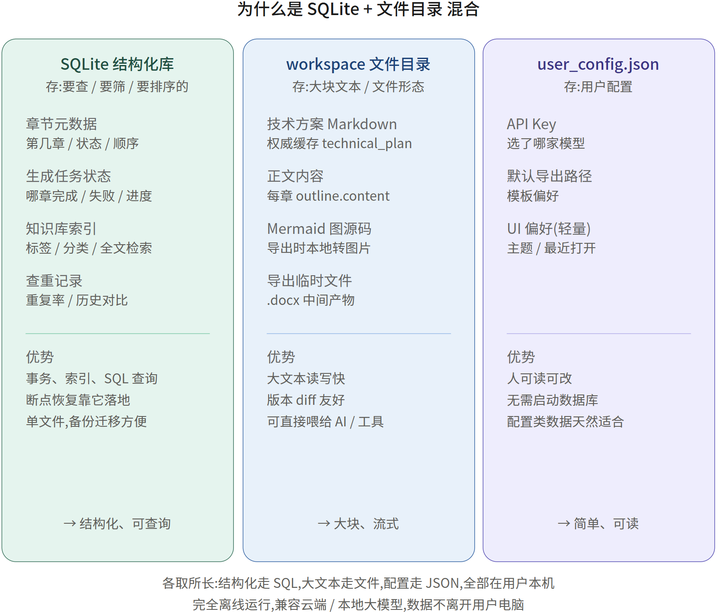
结构走 SQLite,方便管进度和关系;内容走文件,方便扛超长标书。混搭是为了又快查又扛得住大稿,两套介质各管一块,不是把同一份业务数据存两遍。
Prompt 提示词工程
1. 先拆任务,再写 Prompt
不要把全部文档、全部需求塞进一个巨型 Prompt。把大业务拆成流水线,每个阶段对应一组职责单一的 Prompt。
| 阶段 | Prompt 策略 |
|---|---|
| 文档解析 | 多套定向提取 Prompt,分别拿概述、评分项、结构化 JSON 字段 |
| 目录生成 | 分组生成子树 → 审核 → 问题局部修复 |
| 正文生成 | 先整体编排规划,再分章节分片生成 |
| 一致性校验 | 独立审计 Prompt 找冲突,再独立修复 Prompt 做局部修改 |
复杂 AI 产品 = 业务流水线 + 多组小 Prompt,不存在万能提示词。
2. 输出契约写死:要什么、禁止什么都写清
Prompt 里明确约束输出格式和禁区:
- 强制输出 JSON,固定 key;无信息统一填
没有提及 - 禁止编造事实、禁止额外解释、禁止脑补业务信息
- Prompt 只做引导,后面必须配套代码校验(
validator/normalize)
大模型尽力输出,程序强制兜底校验。做法是:业务为每次 JSON 请求提供两个函数 → aiService 在 parse 之后强制 normalize → validate → 失败走修复与重试 → 通过才进入后续逻辑与落盘。
模式:Prompt 尽量对,normalize 收容偏差,validator 守业务红线。
配合顺序:
- Prompt 规定理想 JSON 形状
- normalizer 吸收常见偏差(字段名乱、外包一层
result) - validator 卡住业务底线(空目录、重复 ID、非法章节号)
- 失败 → 修复 Prompt / 重试,不把脏结构写入 Store
3. 分四类 Prompt 人格,不要一套 system 通吃
- Extract 提取:温度低,忠于原文;信息缺失固定返回
没有提及(招标解析) - Generate 生成:允许合理扩写,但严格受全局事实约束(标书正文)
- Audit 审计:只找问题、输出冲突证据,不重写全文
- Repair 修复:只输出局部补丁
old_text/new_text,尽量小改,拒绝整段重写
常见坑:全部任务共用同一个 system prompt,提取任务也给高温度,容易乱编。
4. 长文档:segment-map-merge
面对远超上下文窗口的长文档:
- 文档切片,每段独立提取(map)
- 用专门的合并 Prompt 把多段结果归一
- 合并约定:
本段未提及不能覆盖其它切片已得到的有效信息
长文本用切段合并,不要硬塞超长文本进单次请求。
5. 主 Prompt + 修复 Prompt 的失败闭环
默认前提:模型一定会出错,要准备兜底修复链路,而不是简单重试原 Prompt。
- JSON 输出失败:走专门 JSON 修复 Prompt,不要原样重跑
- 审计检出事实冲突:修复 Prompt 输出 patch
- 目录审核不通过:交给 Agent 修复 Prompt 局部调目录
窄场景修复 Prompt,通常比重复跑原始大 Prompt 更稳。