ComfyUI 教学笔记:提示词权重、图生图与 ControlNet
反向提示词并不能把不想要的东西从画面里彻底抹掉,它调的是画面中的权重。要完全根除,还需要别的操作。
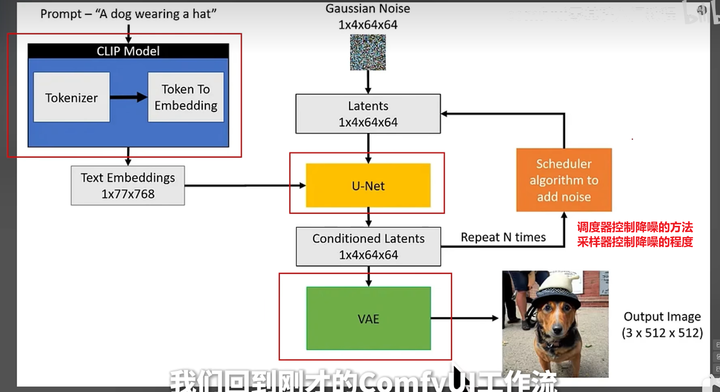
扩散模型
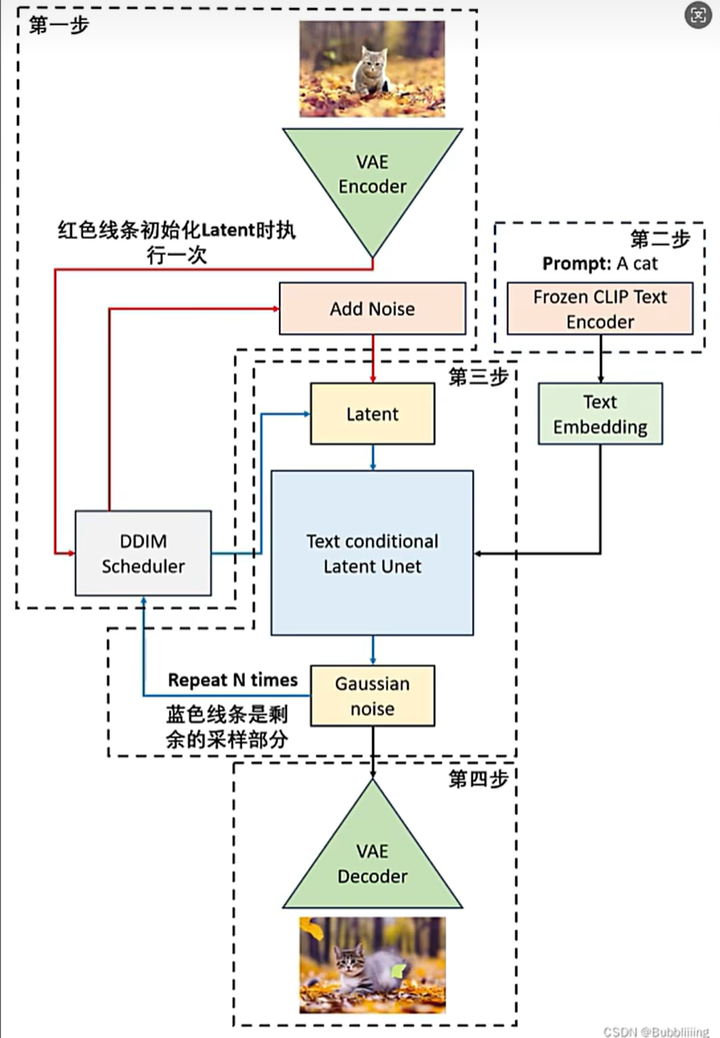
在 Stable Diffusion 这类 AI 生成工具里,用来生成图像的核心模型就是扩散模型(Diffusion Model)。
- 核心原理:逐步向图像中添加噪声,再通过反向过程预测并去除噪声,最终生成高质量图像。
- Qwen、SeedVR2 等模型,本质上也都是基于扩散 / 流匹配机制的变体,只是架构和优化方向不同。
提示词书写顺序
写提示词时:先写质量词汇(杰作、高质量、极致的细节),再写主体,最后写氛围词汇。
越靠前的词汇权重越大,整体画面里的占比也更大。
图生图:K 采样器的降噪
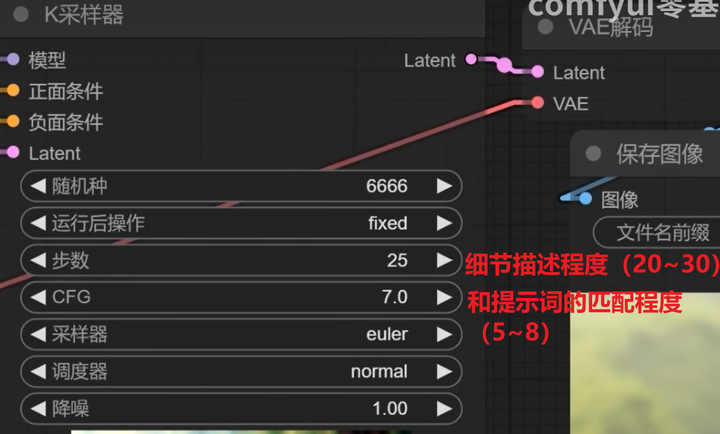
图生图时,K 采样器里的降噪不能设成 1.00。那样等于给原图铺满噪点再去噪,原图结构会丢光。应设成 0.6 一类数值,按一定比例降噪,才能保住和原图的相似度。
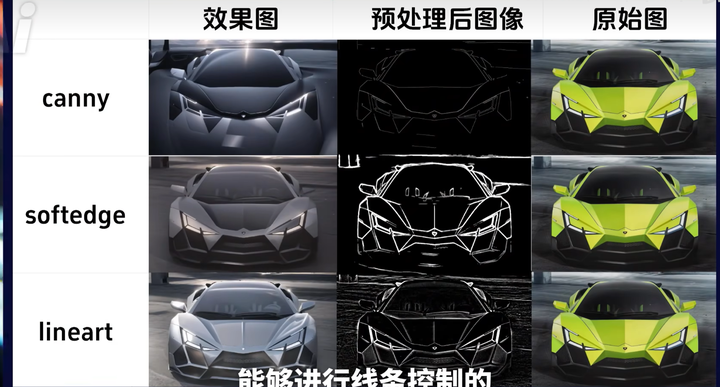
ControlNet 效果
常用:线条、软边缘、OpenPose、Depth。
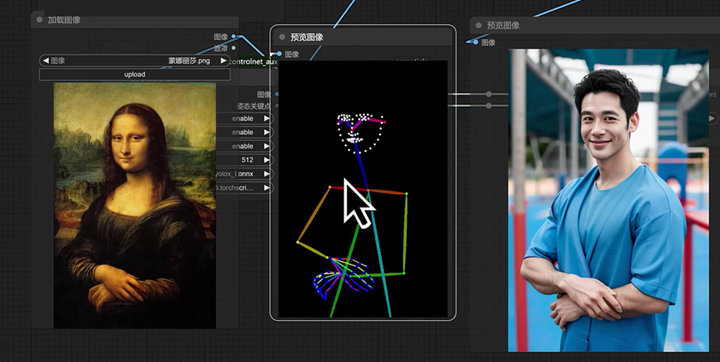
OpenPose
可以先做骨骼图分析,用来稳定人物的姿势、姿态。
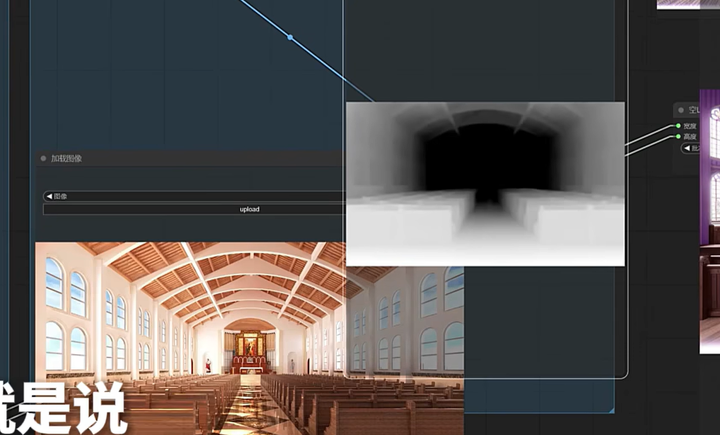
Depth
让图片有纵深感和空间感。
调用别人的模型
借鉴别人的工作流时,会给出相关参数参考,再按自己的目标做微调。
精准视频或项目反推提示词(Gemini)
VideoAnalysisService(视频解析)
- 视频处理核心:FFmpeg(用 FFmpeg.AutoGen / FFmpeg.NET 等 .NET 绑定库调用)
- 解封装、解码、拆帧
- 提取关键帧、按间隔抽帧
- AI 分析:
- 调用大模型 API(通义千问、火山引擎)做镜头识别、场景理解
- 封装在
Infrastructure/AI层,用HttpClient或 SDK 发起请求
- 图像数据处理:SixLabors.ImageSharp 或 SkiaSharp 做帧格式转换、缩放、裁剪
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 Rock的博客!