Redis 进阶:为何快、I/O 复用,以及 String / Hash / List / Set / ZSet / Geo
Redis 全称 Remote Dictionary Server,远程字典服务。本质是一个内存数据库服务器:启动 redis-server 就启动了一个专门处理键值对的网络服务进程,对外提供存储、缓存、发布订阅等能力,角色和 Web 服务器、数据库服务器一样。
相关讲解:Redis 是什么、架构怎么设计 · 主从 / 哨兵 / 哨兵集群 · 集群如何工作
为何快
- 内存存储:读写落在内存,延迟低。
- 单线程模型:避免多线程竞争和同步开销。
- 非阻塞 I/O 与事件驱动:用 I/O 多路复用同时盯一批连接,有数据再处理。
I/O 多路复用
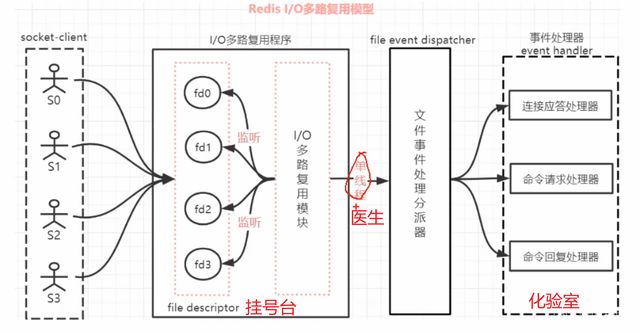
一个线程监听多个 socket:哪个连接就绪就处理哪个,不必为每个客户端开一条阻塞线程。这是 Redis 能撑高并发、又保持单线程模型的关键。
Spring Data Redis 与序列化
Spring Data Redis 是专门操作 Redis 服务器的框架模块。
序列化要点:
- 序列化:内存数据 → 字节 / 字符串,方便存储和传输
- 反序列化:字节 / 字符串 → 内存数据,还原后使用
- Spring Boot 操作 Redis 时,序列化的核心作用是让复杂对象能正常写入、读出 Redis
用 String 存对象时,JSON 序列化就是其中一种落地方式,见下一节对比。
String
用 String 存用户对象,常见两种做法:
| 方案 | 示例 | 优点 | 缺点 |
|---|---|---|---|
| JSON 序列化 | SET user:1 '{"name":"roy"}' |
Key 少,读写一次完成 | 字段修改麻烦,并发易冲突 |
| 字段拆分 | MSET user:1:name roy user:1:balance 1888 |
支持字段级读写,并发友好 | Key 数量多,维护成本高 |
Hash
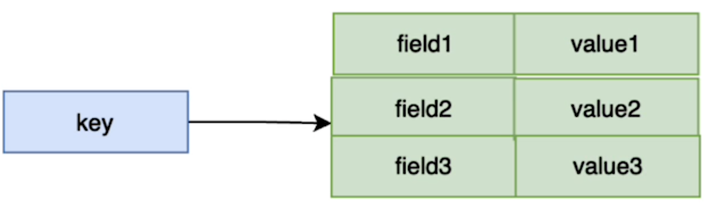
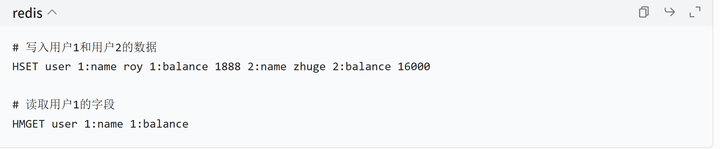
优点:
- 语义清晰:一个用户对应一个 Hash,天然适配对象结构
- 字段级操作:可用
HSET单独改某一个字段,不用动整个对象 - 独立控制:可给每个用户单独设过期,如
EXPIRE user:1 3600 - 性能友好:单个 Hash 大小可控,操作效率高
List
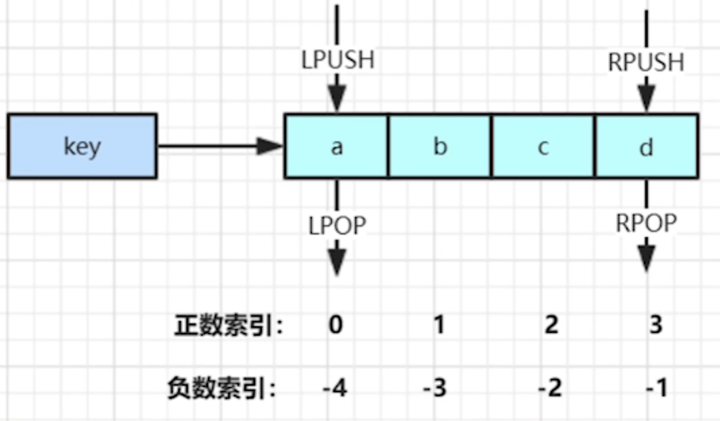
| 数据结构 | Redis 命令组合 | 原理 |
|---|---|---|
| 栈(Stack,后进先出) | LPUSH + LPOP |
从左侧压入,也从左侧弹出 |
| 队列(Queue,先进先出) | LPUSH + RPOP |
从左侧压入,从右侧弹出 |
| 阻塞队列(Blocking MQ) | LPUSH + BRPOP |
用 BRPOP 替代 RPOP;列表为空时消费端阻塞等待,直到有新数据 |
Set
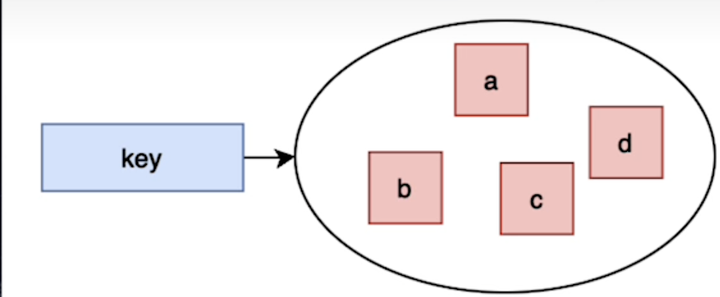
集合里没有重复数据。
| 命令 | 作用 | 适用场景 |
|---|---|---|
SADD key member |
向集合添加元素,自动去重 | 记录参与用户,防重复 |
SMEMBERS key |
获取集合中所有元素 | 查看全部参与用户 |
SRANDMEMBER key [count] |
随机返回指定数量元素,不删除 | 可重复中奖、多轮抽奖 |
SPOP key [count] |
随机返回并删除指定数量元素 | 不可重复中奖,保证公平 |
ZSet(有序集合)
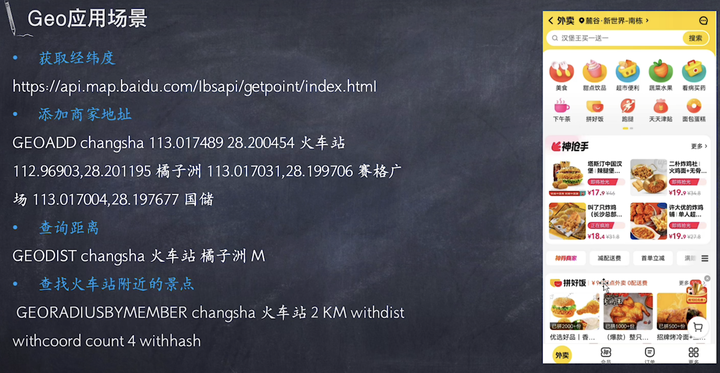
Geo:地理空间
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 Rock的博客!