黑马顺风车项目:GEO 匹配、死信超时与跨实例 WebSocket
顺风车核心难点:两端定位、行程坐标匹配、即时通讯、剩余座位、邀请超时、高并发坐标同步。
难点分析
- 两端定位与记录:司机和乘客位置如何实时定位并记录
- 行程坐标匹配:双方行程坐标点如何设计匹配
- 即时通讯:洽谈与实时通讯的技术方案
- 座位数统计:匹配成功后如何统计司机剩余座位
- 超时处理:司机发出邀请后乘客无响应如何超时
- 高并发坐标同步:高并发下行程坐标的实时记录与同步
技术选型
后端:SpringCloud + Nacos + Gateway + OpenFeign
前端:H5 + CSS + jQueryMobile;Nginx 动静分离;对接地图、WebSocket、通用接口
存储:
- MySQL:基础业务数据
- MongoDB:即时通讯、实时位置(偏冷数据落库)
- Redis:缓存(设计是难点)+ 实时位置与 GEO 运算
- FastDFS:文件存储
消息与通信:RabbitMQ + Kafka + WebSocket
其他:Swagger2 接口文档
微服务模块
| 分类 | 模块 |
|---|---|
| 基础设施 | 注册中心 Nacos、网关 Gateway |
| 业务 | 行程 stroke、订单 order、用户 account、支付 payment |
| 底层 | 存储 storage、消息 notice |
相关思考
- 选型时要想清楚:现有需求与后期扩展是否吃得下;这个方案相对别的方案,独到点在哪里。
- GEO 地理位置存储:专门存经纬度、点位、轨迹、区域。可选 Redis 或 MongoDB。匹配场景选 Redis:除了存,还要大量距离运算,纯内存实时性更好。MongoDB 可存行车轨迹这类偏冷、少算距离的位置数据。
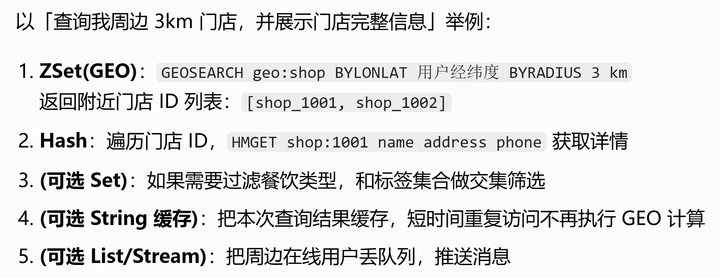
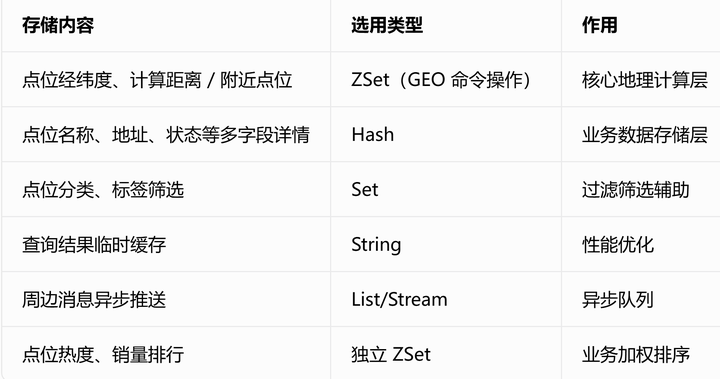
- 引入 Redis 之后的真正难点:怎么搭配多种数据类型。这里才真正体现技术。
FastDFS:小文件专用存储
业务需求:海量身份认证图、车辆照片;以小图为主;写少读多、安全要求高;量会变大,读速要够但不必毫秒级;要有冗余备份,安装部署尽量简单。
了解即可:现在新项目基本都用 MinIO。
通用分布式文件系统开发体验好,但复杂、性能一般;专用系统开发体验差一些,但复杂低、性能高。FastDFS 适合图片等小文件:不对文件分块,没有分块合并开销;网络用 socket,通信快。
- 通用:万能型,大文件小文件、离线在线都想兼顾
- 专用:场景定制。FastDFS 专为互联网中小文件在线存取
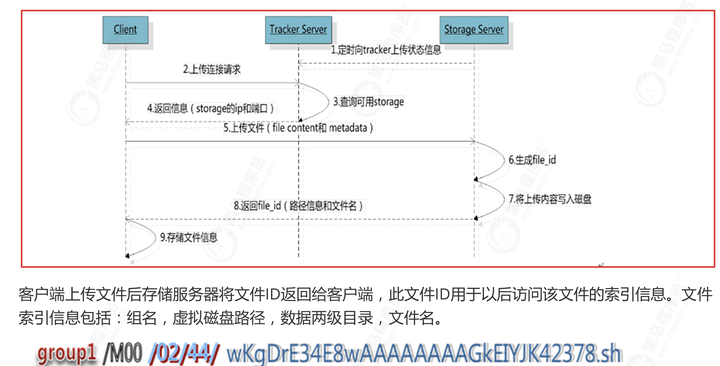
存入 storage 后,会返回文件地址给 client。
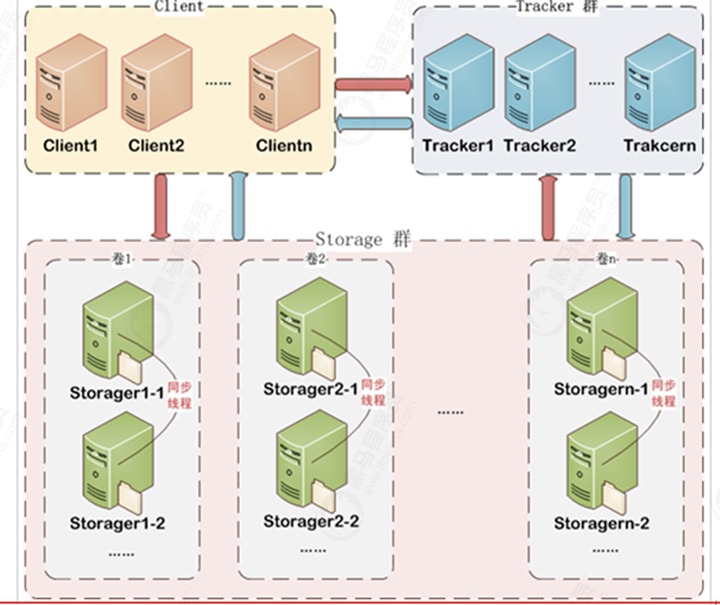
同一卷内各 storage 共享;整卷最大容量由最小那台决定。要横向扩容可加卷。
司机行程发布与 Redis 搭配
GEO 底层是 GeoHash:把地球不断切片,编成类似 10111 的一维索引,用来索引经纬度。
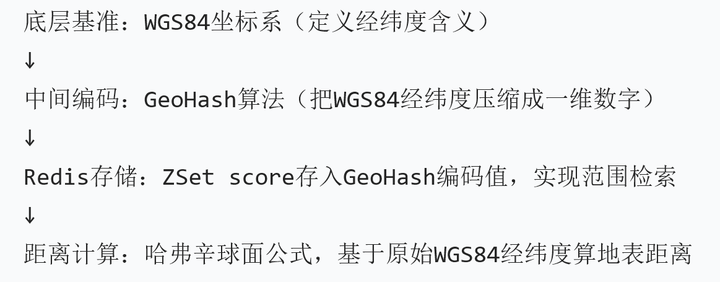
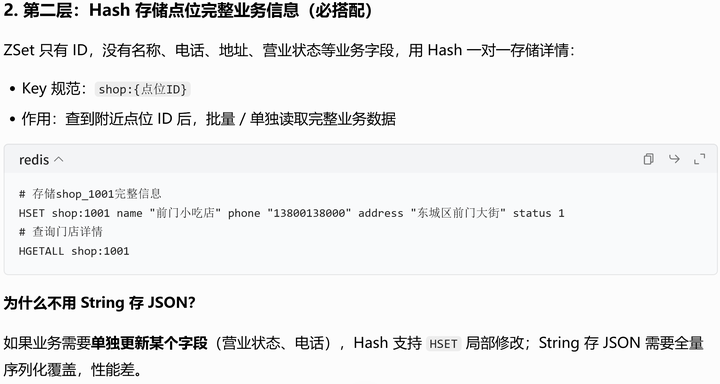
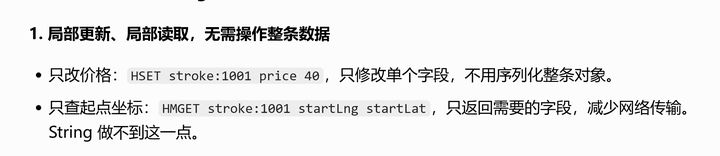
如何搭配 Redis 数据类型
数据热处理
数据一入库就计算并写好结果,供后续匹配直接用。
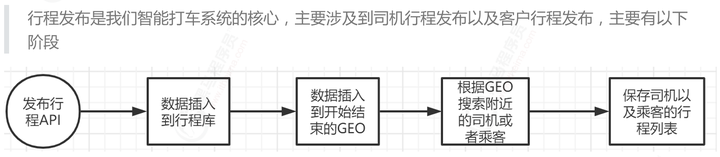
说明:zhash 是项目里用的有序哈希结构表述;hash 是 Redis 原生普通哈希。
超时:死信队列
可选方案:
- 数据库轮询查超时
- Java 内存队列 + 定时器
- 常规分布式手段:死信队列
| 方案 | 延迟精度 | 分布式 | 可靠性 | 性能影响 | 适用场景 |
|---|---|---|---|---|---|
| 死信队列(RabbitMQ) | 较高(秒级) | 支持 | 高(消息持久化) | 无额外数据库压力 | 分布式、中大型项目 |
| 数据库轮询 | 低(分钟级) | 支持 | 高 | 高(频繁查库) | 小型、精度要求低 |
| Java 内存队列 | 高(毫秒级) | 不支持 | 低(重启丢失) | 中 | 单机、非核心超时 |
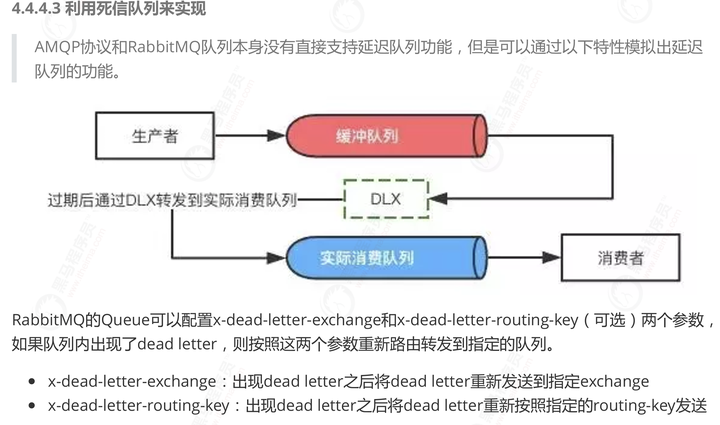
死信链路都在 RabbitMQ 里
- 生产者发到缓冲队列
- 缓冲队列设 TTL(
x-message-ttl) - 过期后经死信交换机(DLX)转发到业务队列
- 消费者监听业务队列处理
邀请完整流转:「延迟必达 + 消费时状态校验」
- 不主动删缓冲队列里的消息(复杂、慢)。每条都走到超时;消费时查 Redis 状态:已确认 / 已取消则忽略;否则改成已超时。
- 消费完成取决于 Ack:RabbitMQ 收到确认后才从队列删除。
业务例子:下单后 30 分钟未支付自动关单——发 TTL=30 分钟的缓冲消息 → 超时进死信 → 业务队列消费者查状态,未支付则关单。
确认同行后的缓存清理
用户确认邀请后,其他未能同行的司机侧邀请、以及 zset 距离列表里与该用户相关的数据要删掉。司机自身位置表虽也有关联,可暂留,等同行完成再一起销毁。目的:少遍历不必删的表,提高效率。
开闭原则与装饰器
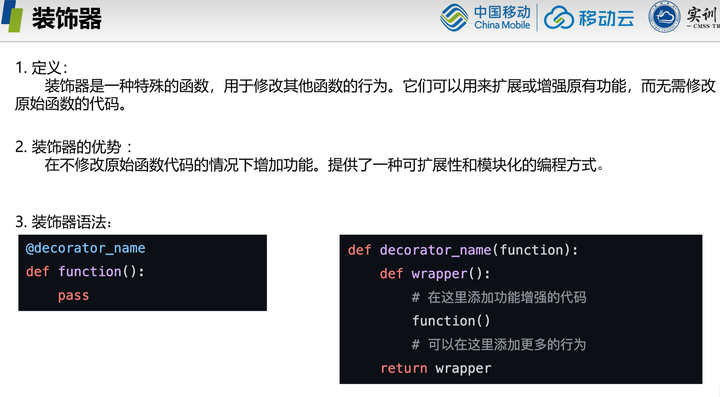
对扩展开放,对修改关闭:新增功能尽量不改成熟代码,用新增代码实现。
装饰器生活例子:基础 Coffee(10 元),再叠 MilkDecorator(+3)、SugarDecorator(+1)、IceDecorator(+0.5)。
WebSocket:跨实例推送
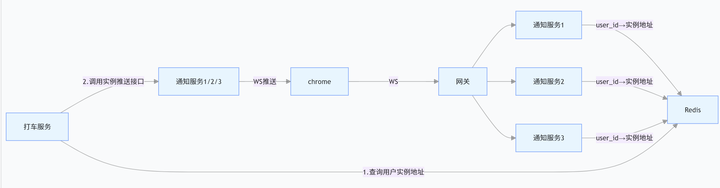
要解决跨实例推送,必须补上「用户 → 实例」映射,通常放 Redis。
优化后的 A↔B 流程:
- 建连:A 连实例 1 → Redis 写
user:A → 实例1;B 连实例 2 → 写user:B → 实例2 - A 发 B:实例 1 写 MongoDB(未读)→ 查 Redis 知 B 在实例 2 → 调实例 2 推送 → 本地 WebSocket 推 B,并标已读
- B 回 A:对称流程
MongoDB 做持久化与离线兜底;在线推送不靠轮询。
数据大屏:按重要性与实时性选架构
binlog 与 Canal
binlog = MySQL 二进制日志,记录数据变更(DML / DDL),不记 SELECT。
作用:数据恢复、主从复制、异构同步(如 Canal 听 binlog 同步到 ES)。
结合架构:
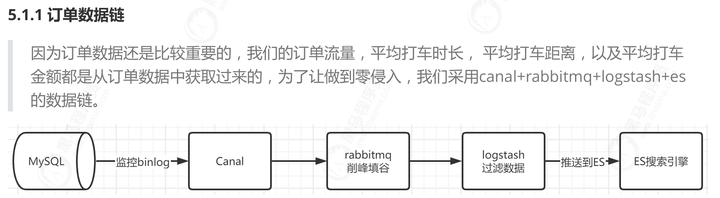
- MySQL 开启 binlog
- 业务改订单 / 行程表 → 写 binlog
- Canal 伪装成从库,拉并解析 binlog
- 结构化数据进 MQ/Kafka → Logstash → ES
| 方式 | 实现逻辑 | 侵入 | 优缺点 |
|---|---|---|---|
| 侵入式 | 写 MySQL 后再写 MQ / ES | 强侵入 | 实时好;业务臃肿、耦合高 |
| 零侵入(Canal + MQ + Logstash + ES) | 听 binlog 异步同步 | 零侵入 | 解耦;依赖 binlog,准实时(秒级) |
直接打 MySQL 适合单条明细;大屏多维聚合若在业务库做 count / group by,会拖交易。Canal 链路把统计压力剥离到 ES,MQ 削峰;代价是链路长、准实时,不适合强实时明细。
- MySQL:线上交易(写 + 单条明细读)
- ES:大屏聚合统计
行程坐标 vs 订单数据
行程坐标特点不同,架构也不同:
- 高频时序:司机每秒上报,高峰可能每秒上万条
- 实时性高:地图轨迹延迟不能太高
- 可容忍部分丢失:少量点丢不影响整体轨迹
- 要清洗:漂移、异常点需过滤、去重、转
geo_point等
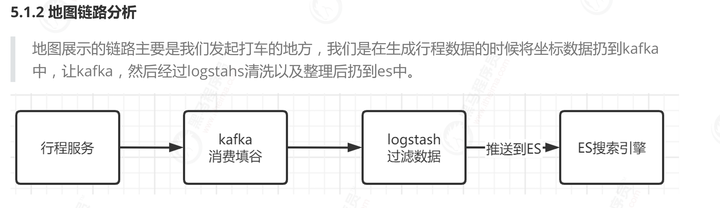
对比 RabbitMQ:Kafka 更适合这种高吞吐坐标流。不是 Kafka 一致性差,而是默认偏性能,可靠性靠配置打开;RabbitMQ 默认更偏可靠。
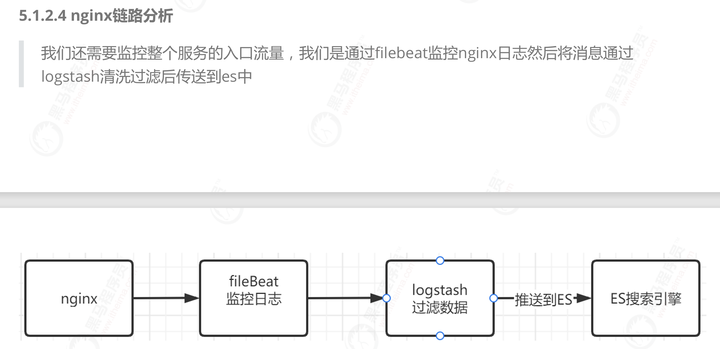
订单、行程链路盯业务核心数据;Nginx 日志链路盯入口表现:高峰流量、报错、慢接口,是平台稳定性的一环。